STUDIO · SPEC SHEET · UNIT S33
把 Aily 装进自己的网站:鉴权、轮询,和 31000 字的分块
——企业白名单只放行一个 AI 入口时,把 Aily 装进自己网站的完整实录
内网自研的网站平台上,有个功能需要大模型帮忙:把一份几万字的业务长文档读一遍,输出结构化的结果。具体是什么业务不重要——这篇文章的重点不是业务本身,而是怎么把飞书 Aily 这个 AI 能力,接进自己的网站里。
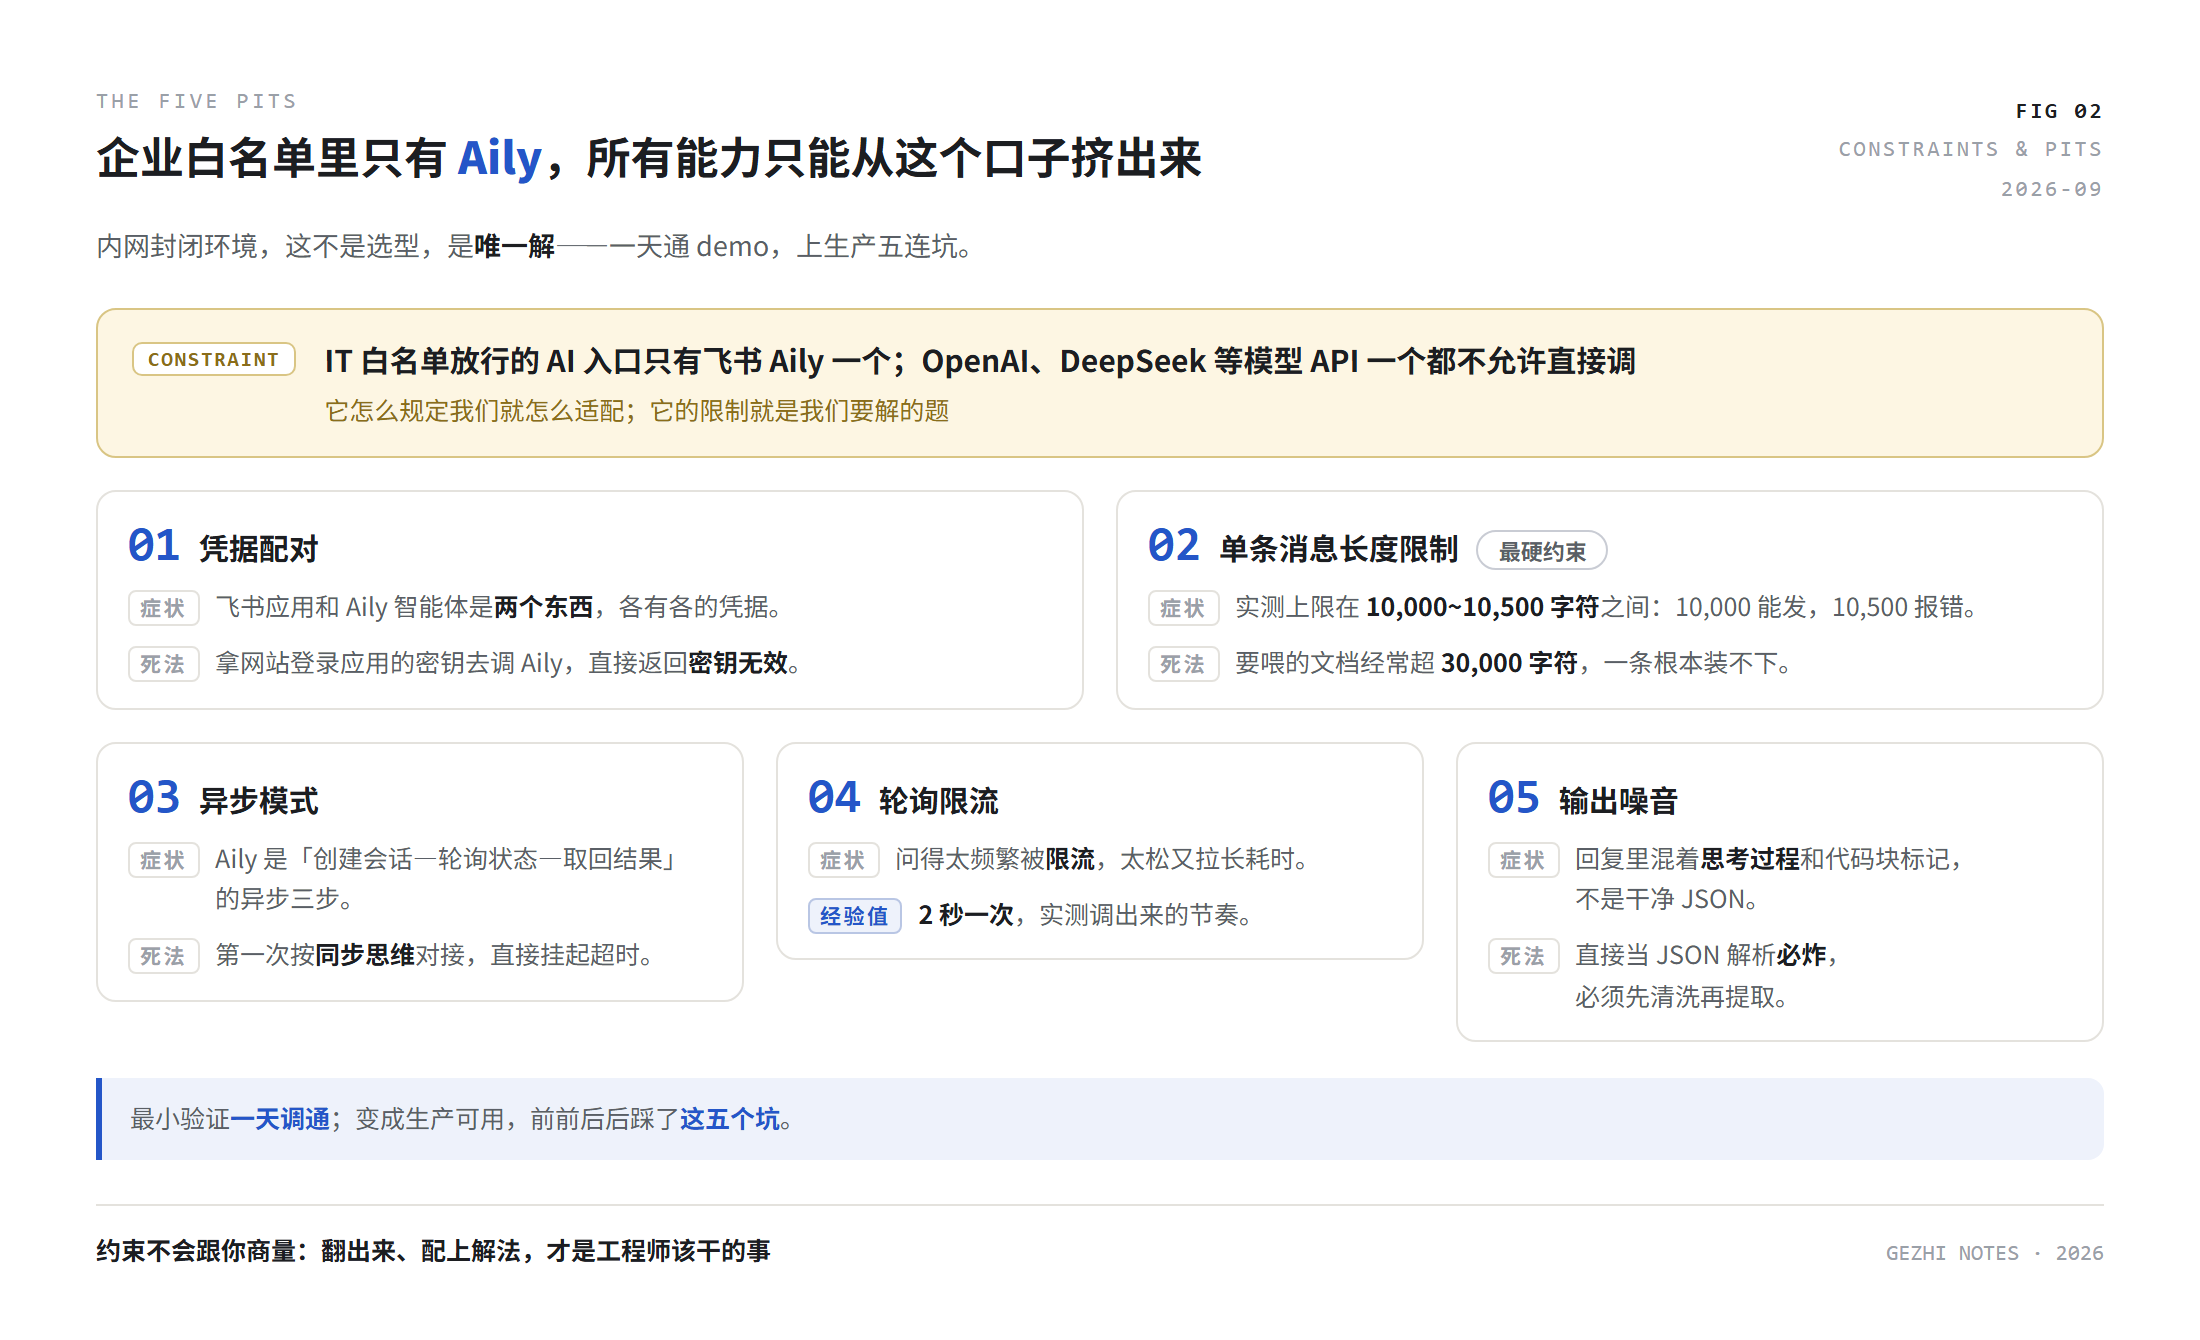
先说背景:为什么是 Aily? 企业环境里,内网是封闭的,IT 白名单放行的 AI 入口只有飞书 Aily 这一个——OpenAI、DeepSeek 这些模型 API,一个都不允许直接调。所以这不是「选型」,是「唯一解」:网站需要的所有大模型能力,都得从 Aily 这一个口子里挤出来。它怎么规定的,我们就怎么适配;它的限制,就是我们要解的题。
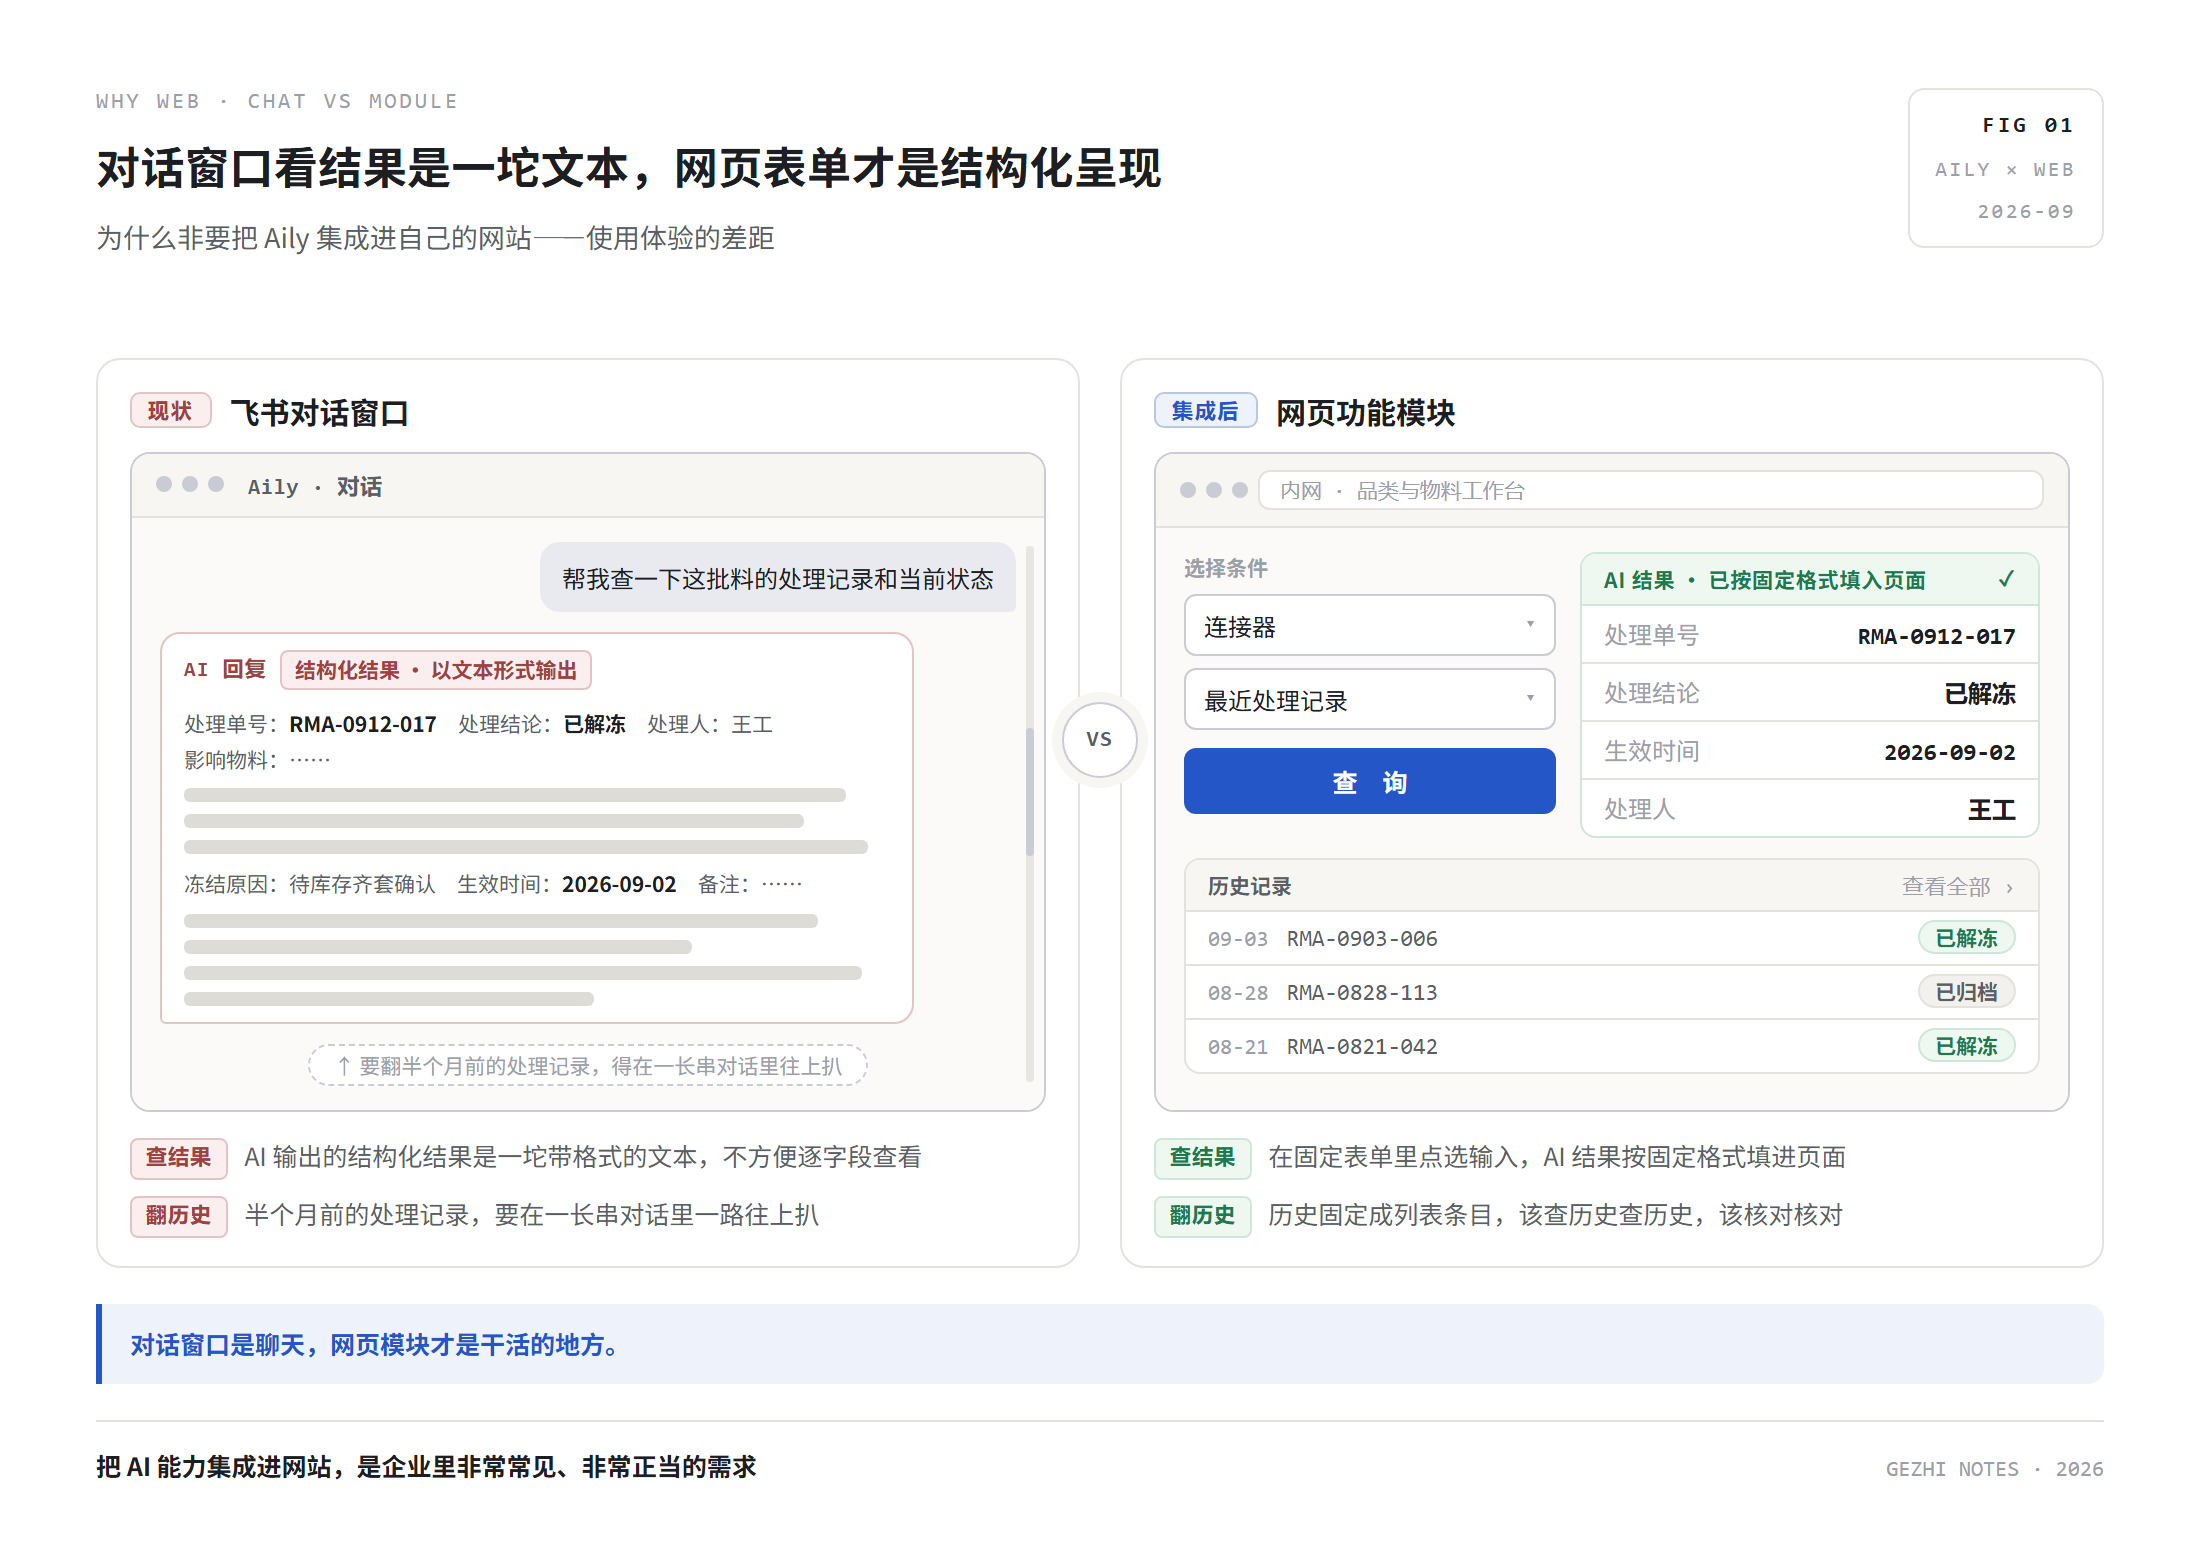
再说为什么非要集成到网站里。Aily 默认的使用渠道是飞书客户端的对话窗口——但对话窗口干正经活并不顺手:AI 输出的结构化结果,在聊天界面里看是一坨带格式的文本,不方便逐字段查看;想翻半个月前的处理记录,在一长串对话里往上扒,也不方便。把它集成到网页上对应的功能模块里就完全不同了:用户在固定表单里点选输入,AI 的结果按固定格式填进页面——标准化、直接,该查历史查历史,该核对核对。所以「把 AI 能力集成到自己的网站」,本身就是企业里非常常见、非常正当的需求,这篇文章讲的正是这件事。
这道题里最硬的一条:Aily 单条消息最多吃 10,000 出头字符,而要喂给它的文档动辄 30,000 字以上。这篇文章讲的就是整个解法——两层身份的鉴权、异步轮询的调用模式,和一个被 31000 字文档逼出来的分块发送方案。
一、痛点:一天通 demo,上生产五连坑
先交代结果:集成的最小验证一天就调通了;但把它变成生产可用,前前后后踩了五个坑——
坑 1:凭据配对。 飞书应用和 Aily 智能体是两个东西,各自绑定不同的应用;拿网站登录那个应用的密钥去调 Aily,直接返回密钥无效。
坑 2:单条消息长度限制。 实测上限在 10,000~10,500 字符之间——10,000 能发,10,500 报错。而我们要喂的文档经常超过 30,000 字符,这是最硬的约束。
坑 3:异步模式。 Aily 不是「发请求—等响应」的同步模式,是「创建会话—轮询状态—取回结果」,第一次按同步思维对接,直接挂起超时。
坑 4:轮询限流。 问得太频繁会被限流,问得太松又拉长耗时——2 秒一次是实测出来的经验值。
坑 5:输出噪音。 模型回复里混着思考过程和代码块标记,直接当 JSON 解析必炸,必须先清洗再提取。
二、鉴权:用户登录是用户登录,AI 调用是 AI 调用
整个链路一句话能说清,但新手最容易在这里犯糊。
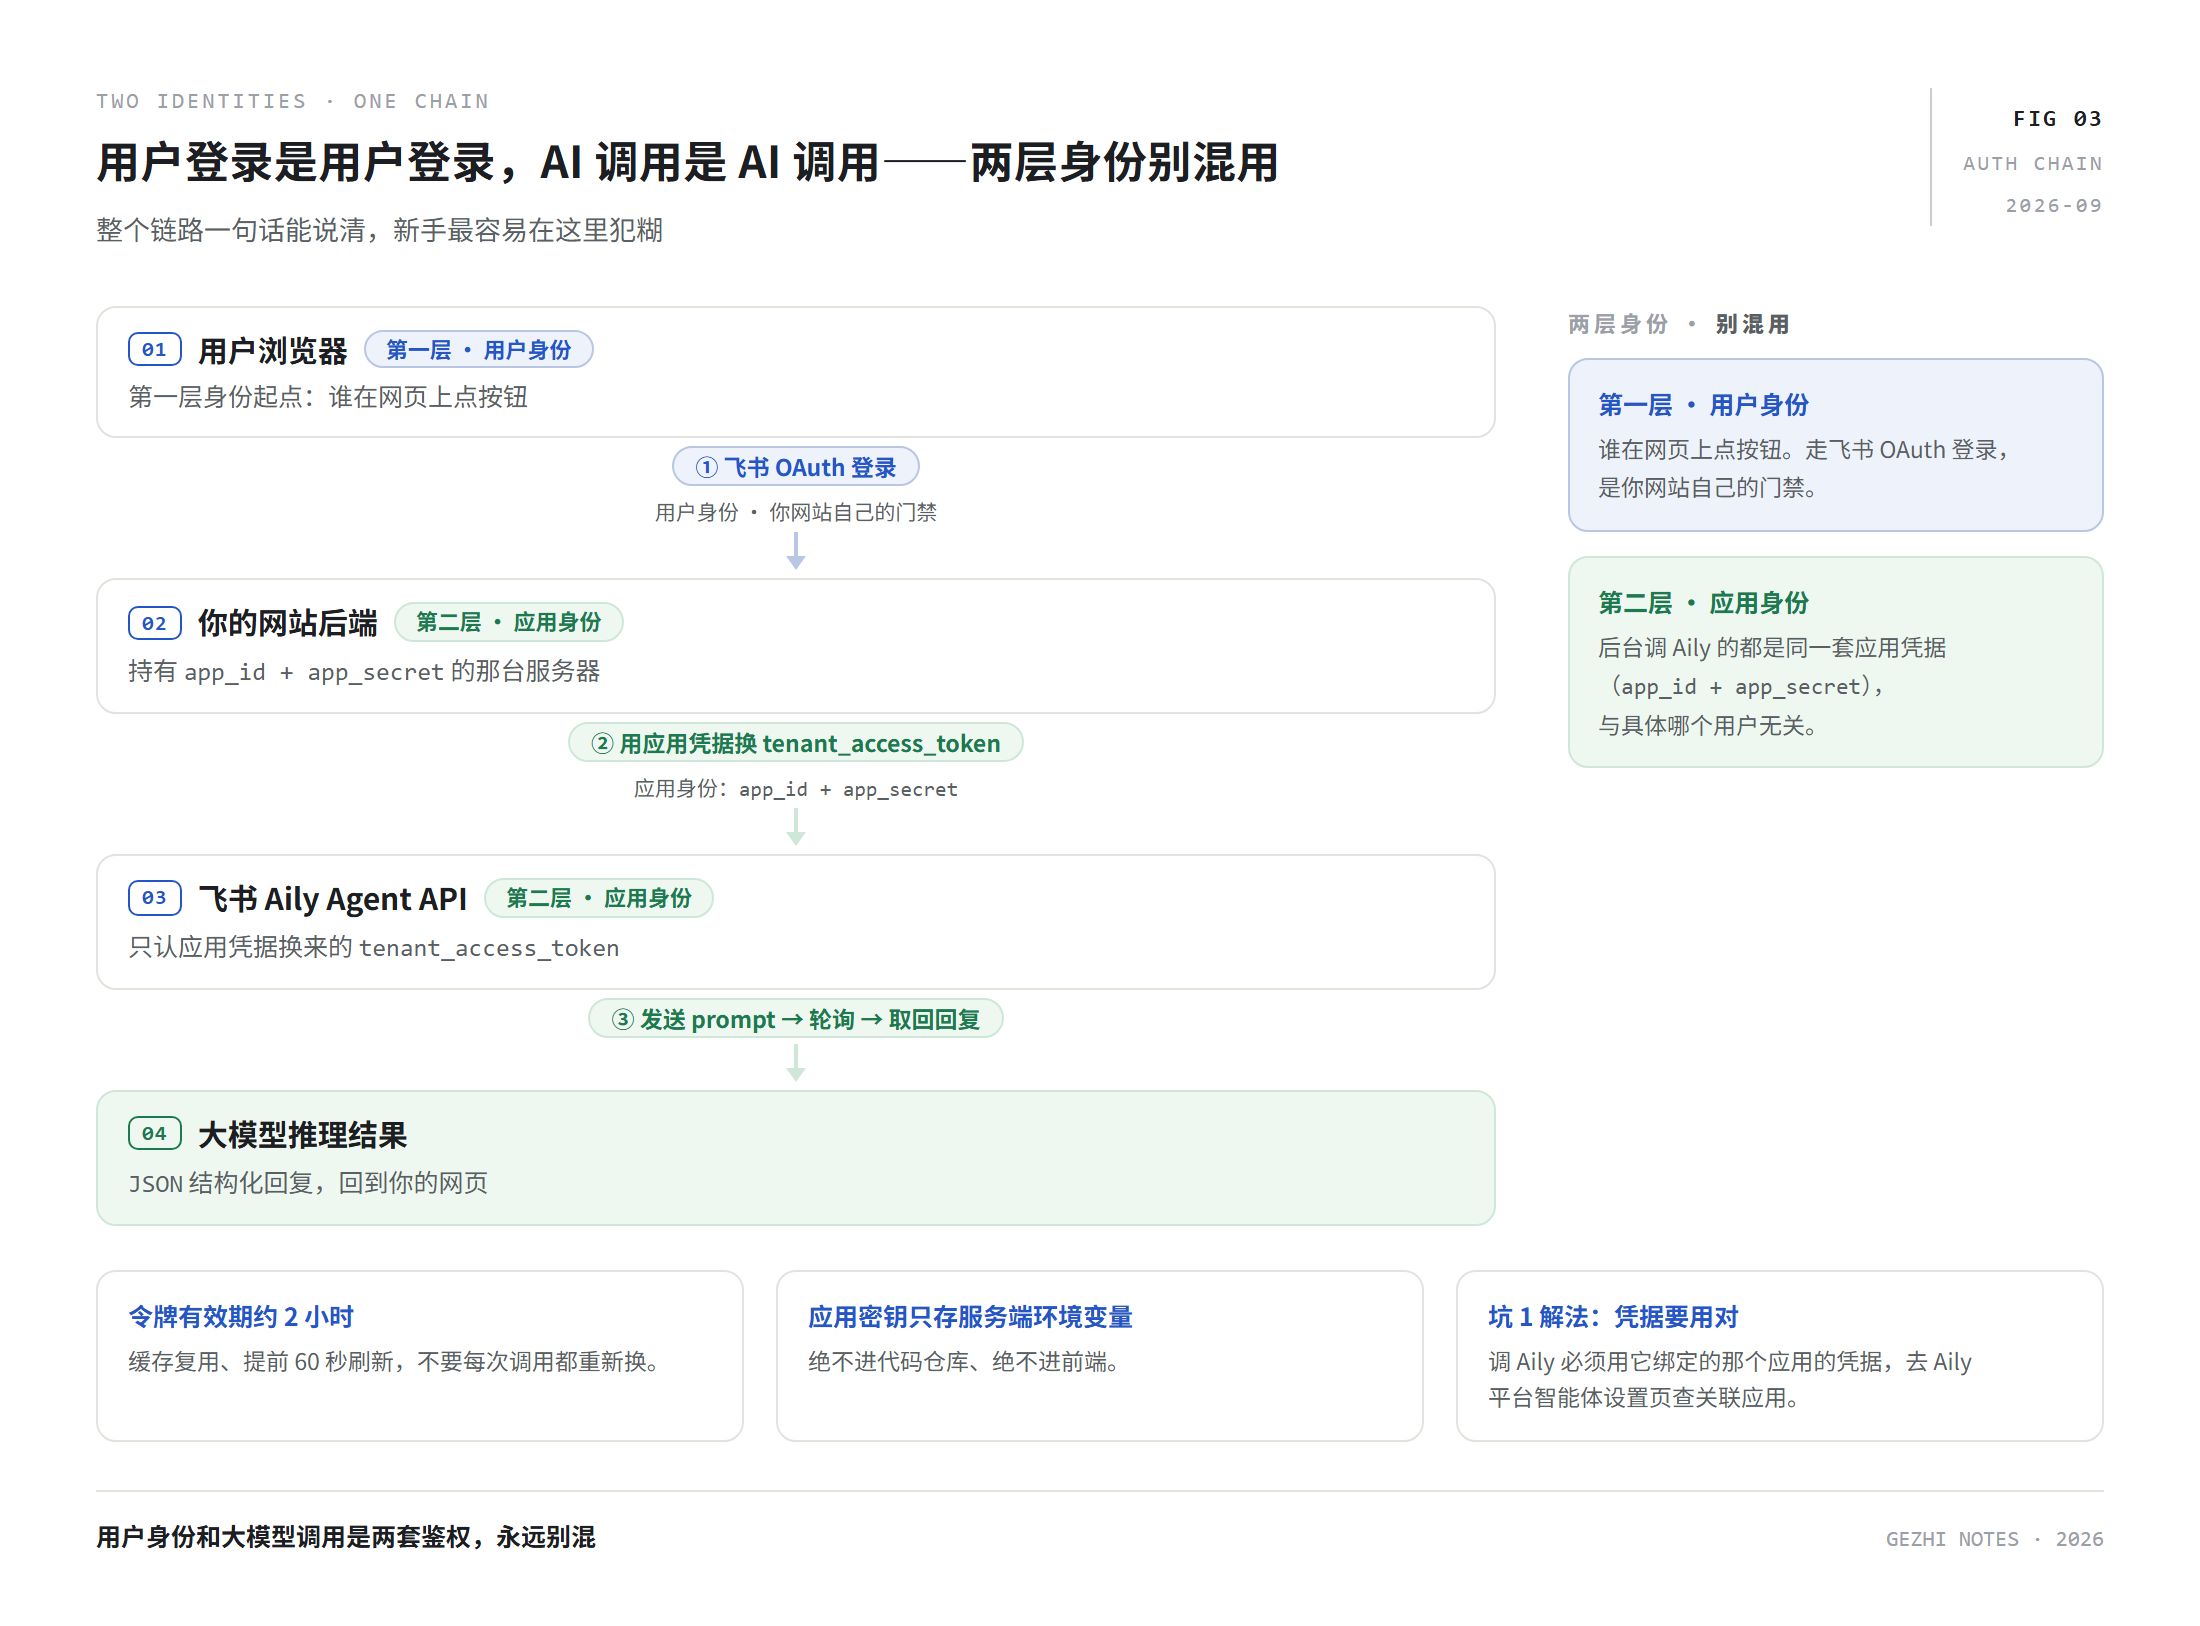
两层身份互不相干:第一层,用户通过飞书 OAuth 登录你的网站,这是网站自己的门禁;第二层,网站后端用应用的 app_id + app_secret 换一个 tenant_access_token,以应用身份去调 Aily——不管哪个用户在网页上点了按钮,后台去调 Aily 的都是同一套应用凭据。
三个生产要点:令牌有效期约 2 小时,缓存复用、提前 60 秒刷新,不要每次调用都重新换;应用密钥只存服务端环境变量,绝不进代码仓库、绝不进前端;坑 1 的解法也在这层——调 Aily 用的凭据必须是它绑定的那个应用的,去 Aily 平台的智能体设置页能查到关联的是哪个应用。
三、调用模式:不是同步等答案,是发完就轮询
Aily 的交互是标准三步:创建会话(把 prompt 发出去,拿回两个 ID——一个用于轮询,一个用于延续对话);轮询状态(每 2 秒问一次「好了没」);取回结果(状态到位后取最终回复)。
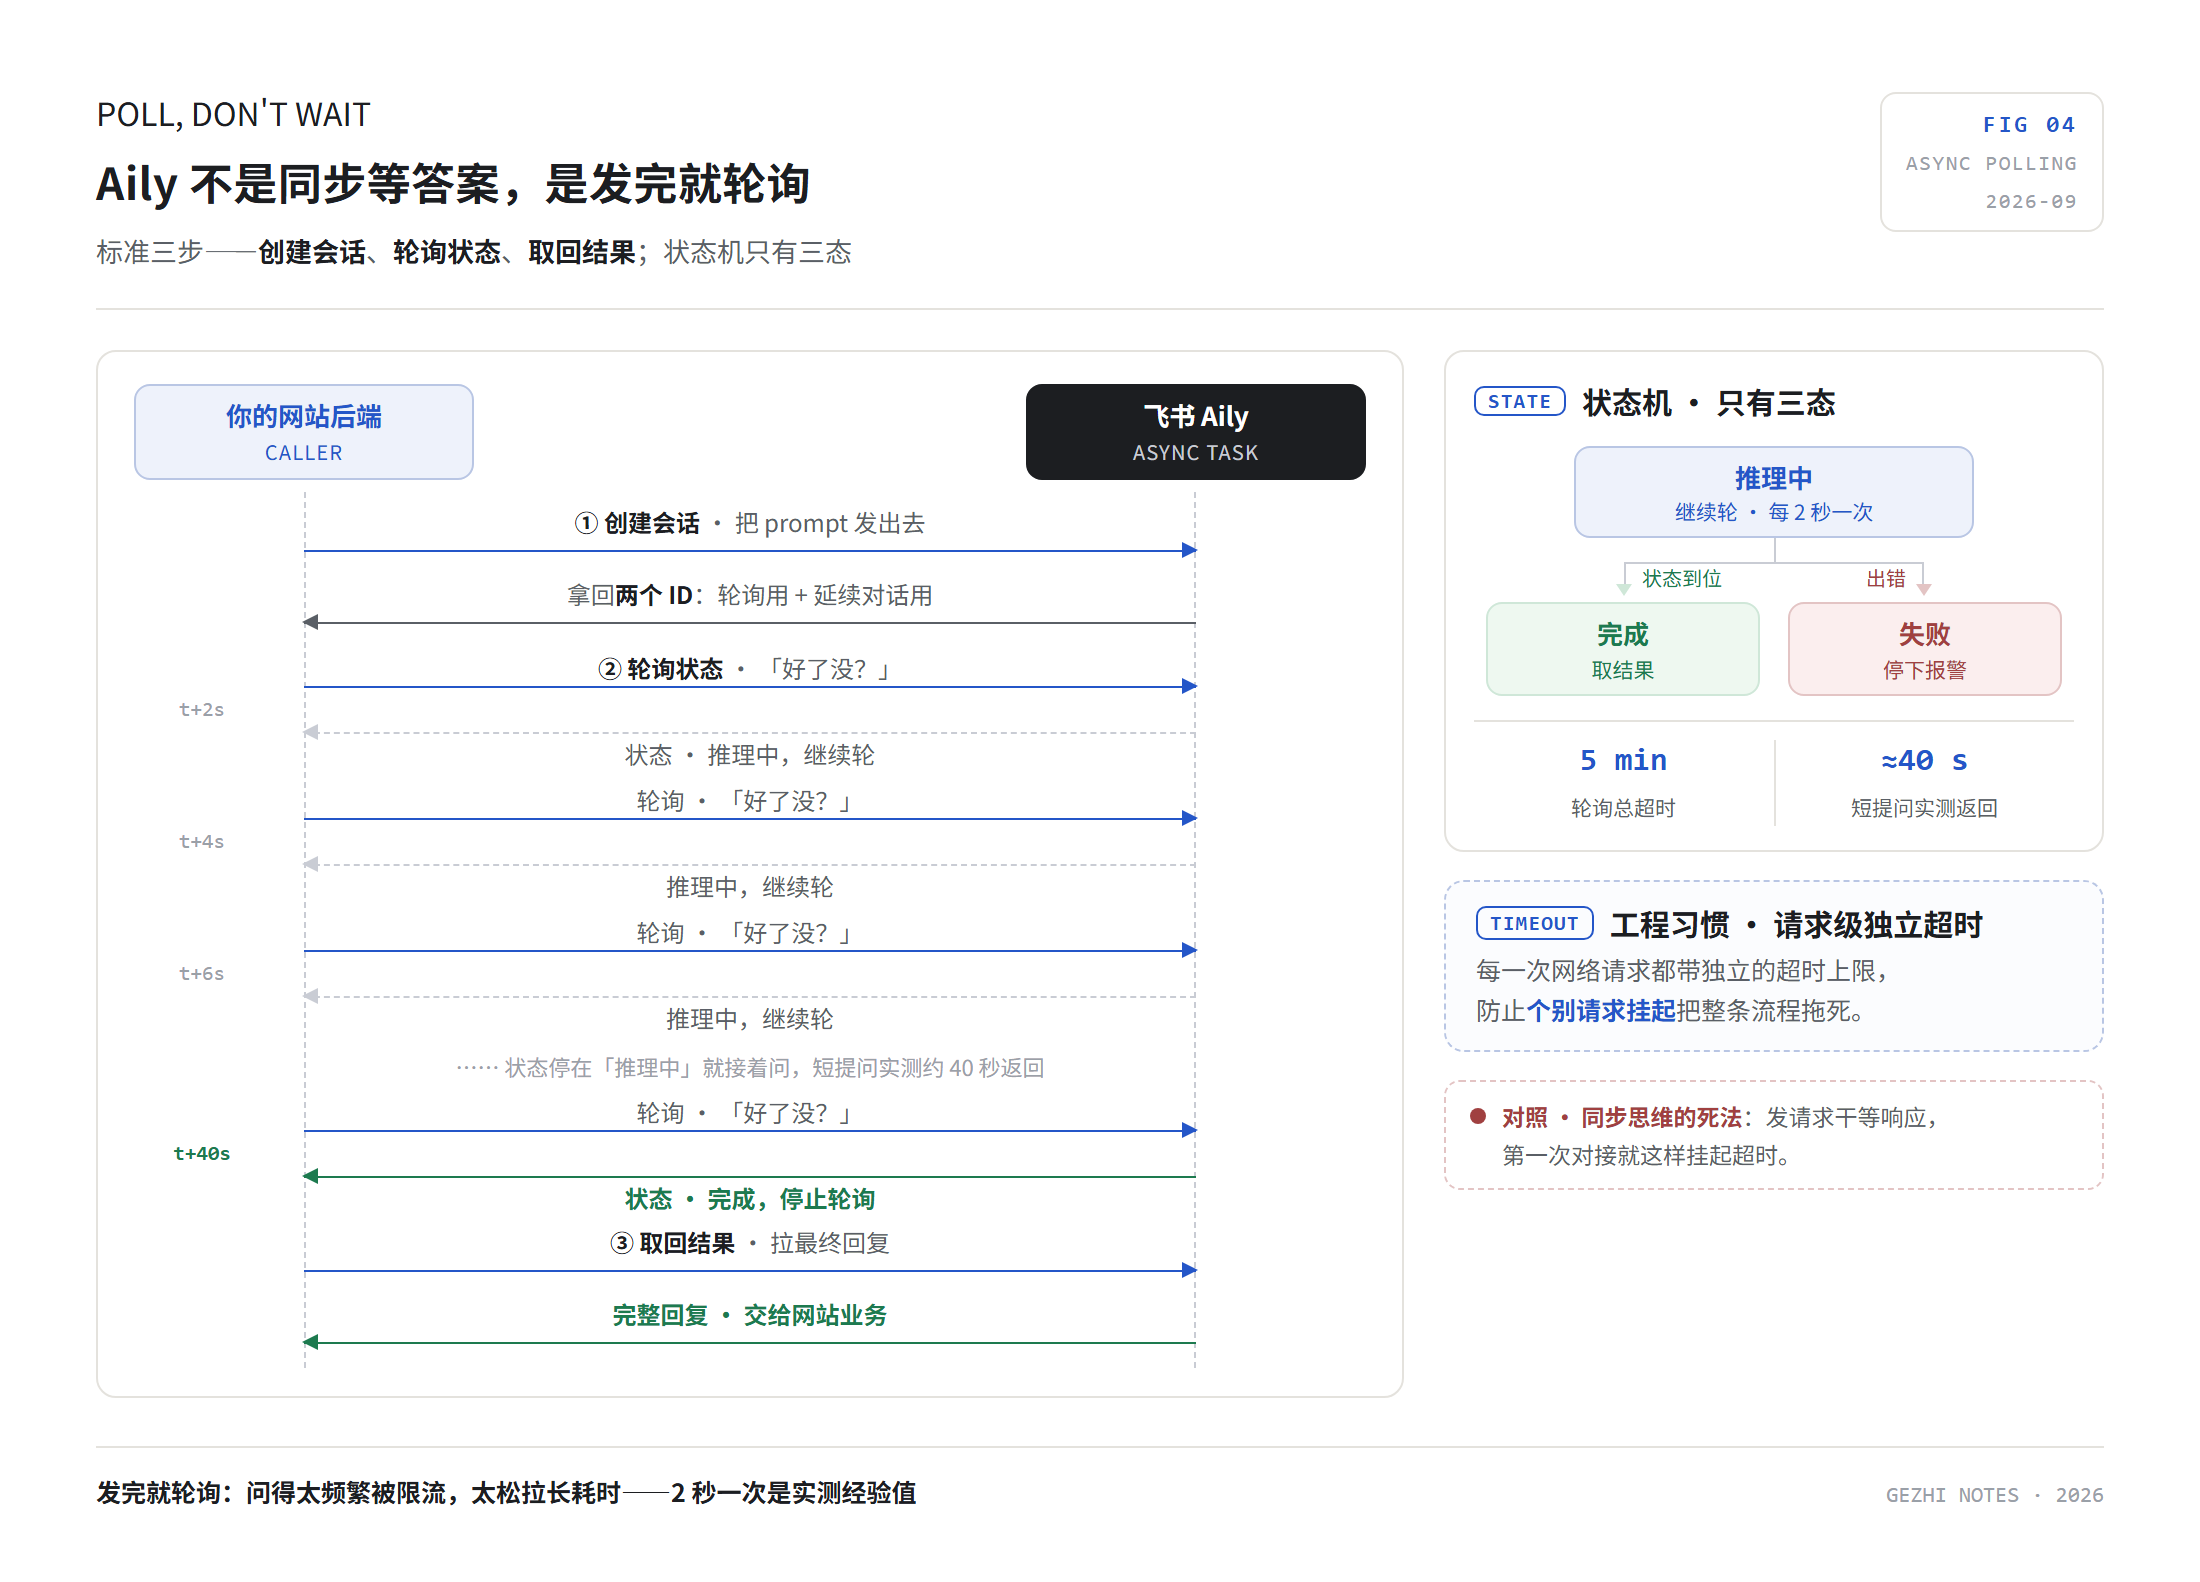
状态机只有三态:推理中(继续轮)、完成(取结果)、失败(停下报警)。轮询总超时 5 分钟——实测短提问约 40 秒返回,足够覆盖。还有一个工程习惯:每一次网络请求都带独立的超时上限,防止个别请求挂起把整条流程拖死。
四、核心:31000 字塞不进去,分 4 块喂
这是整个集成最值钱的一章。
之前: 试过截断。14,500 字符能发出去,但截掉的部分里恰好有关键条目——模型的分析结果直接不完整;截到 8,000 更安全,但丢的内容更多。截断省的是字符,丢的是关键信息,这条路走不通。
现在: 利用 Aily 的会话记忆机制,把长文档分块多轮发送。每块 8,000 字符(给 10,000 的上限留余量),前几块只让模型「接收并记住」,最后一块才让它输出分析:
```
第 1 块:「以下是文档第 1/4 部分,请先接收记住,暂不输出分析,后续还有」
第 2 块:「继续接收第 2/4 部分,暂不输出分析,后续还有」
第 3 块:「继续接收第 3/4 部分,暂不输出分析,后续还有」
第 4 块:文档尾部 + 「以上是完整内容(共 4 部分),请按格式要求直接输出 JSON」
```
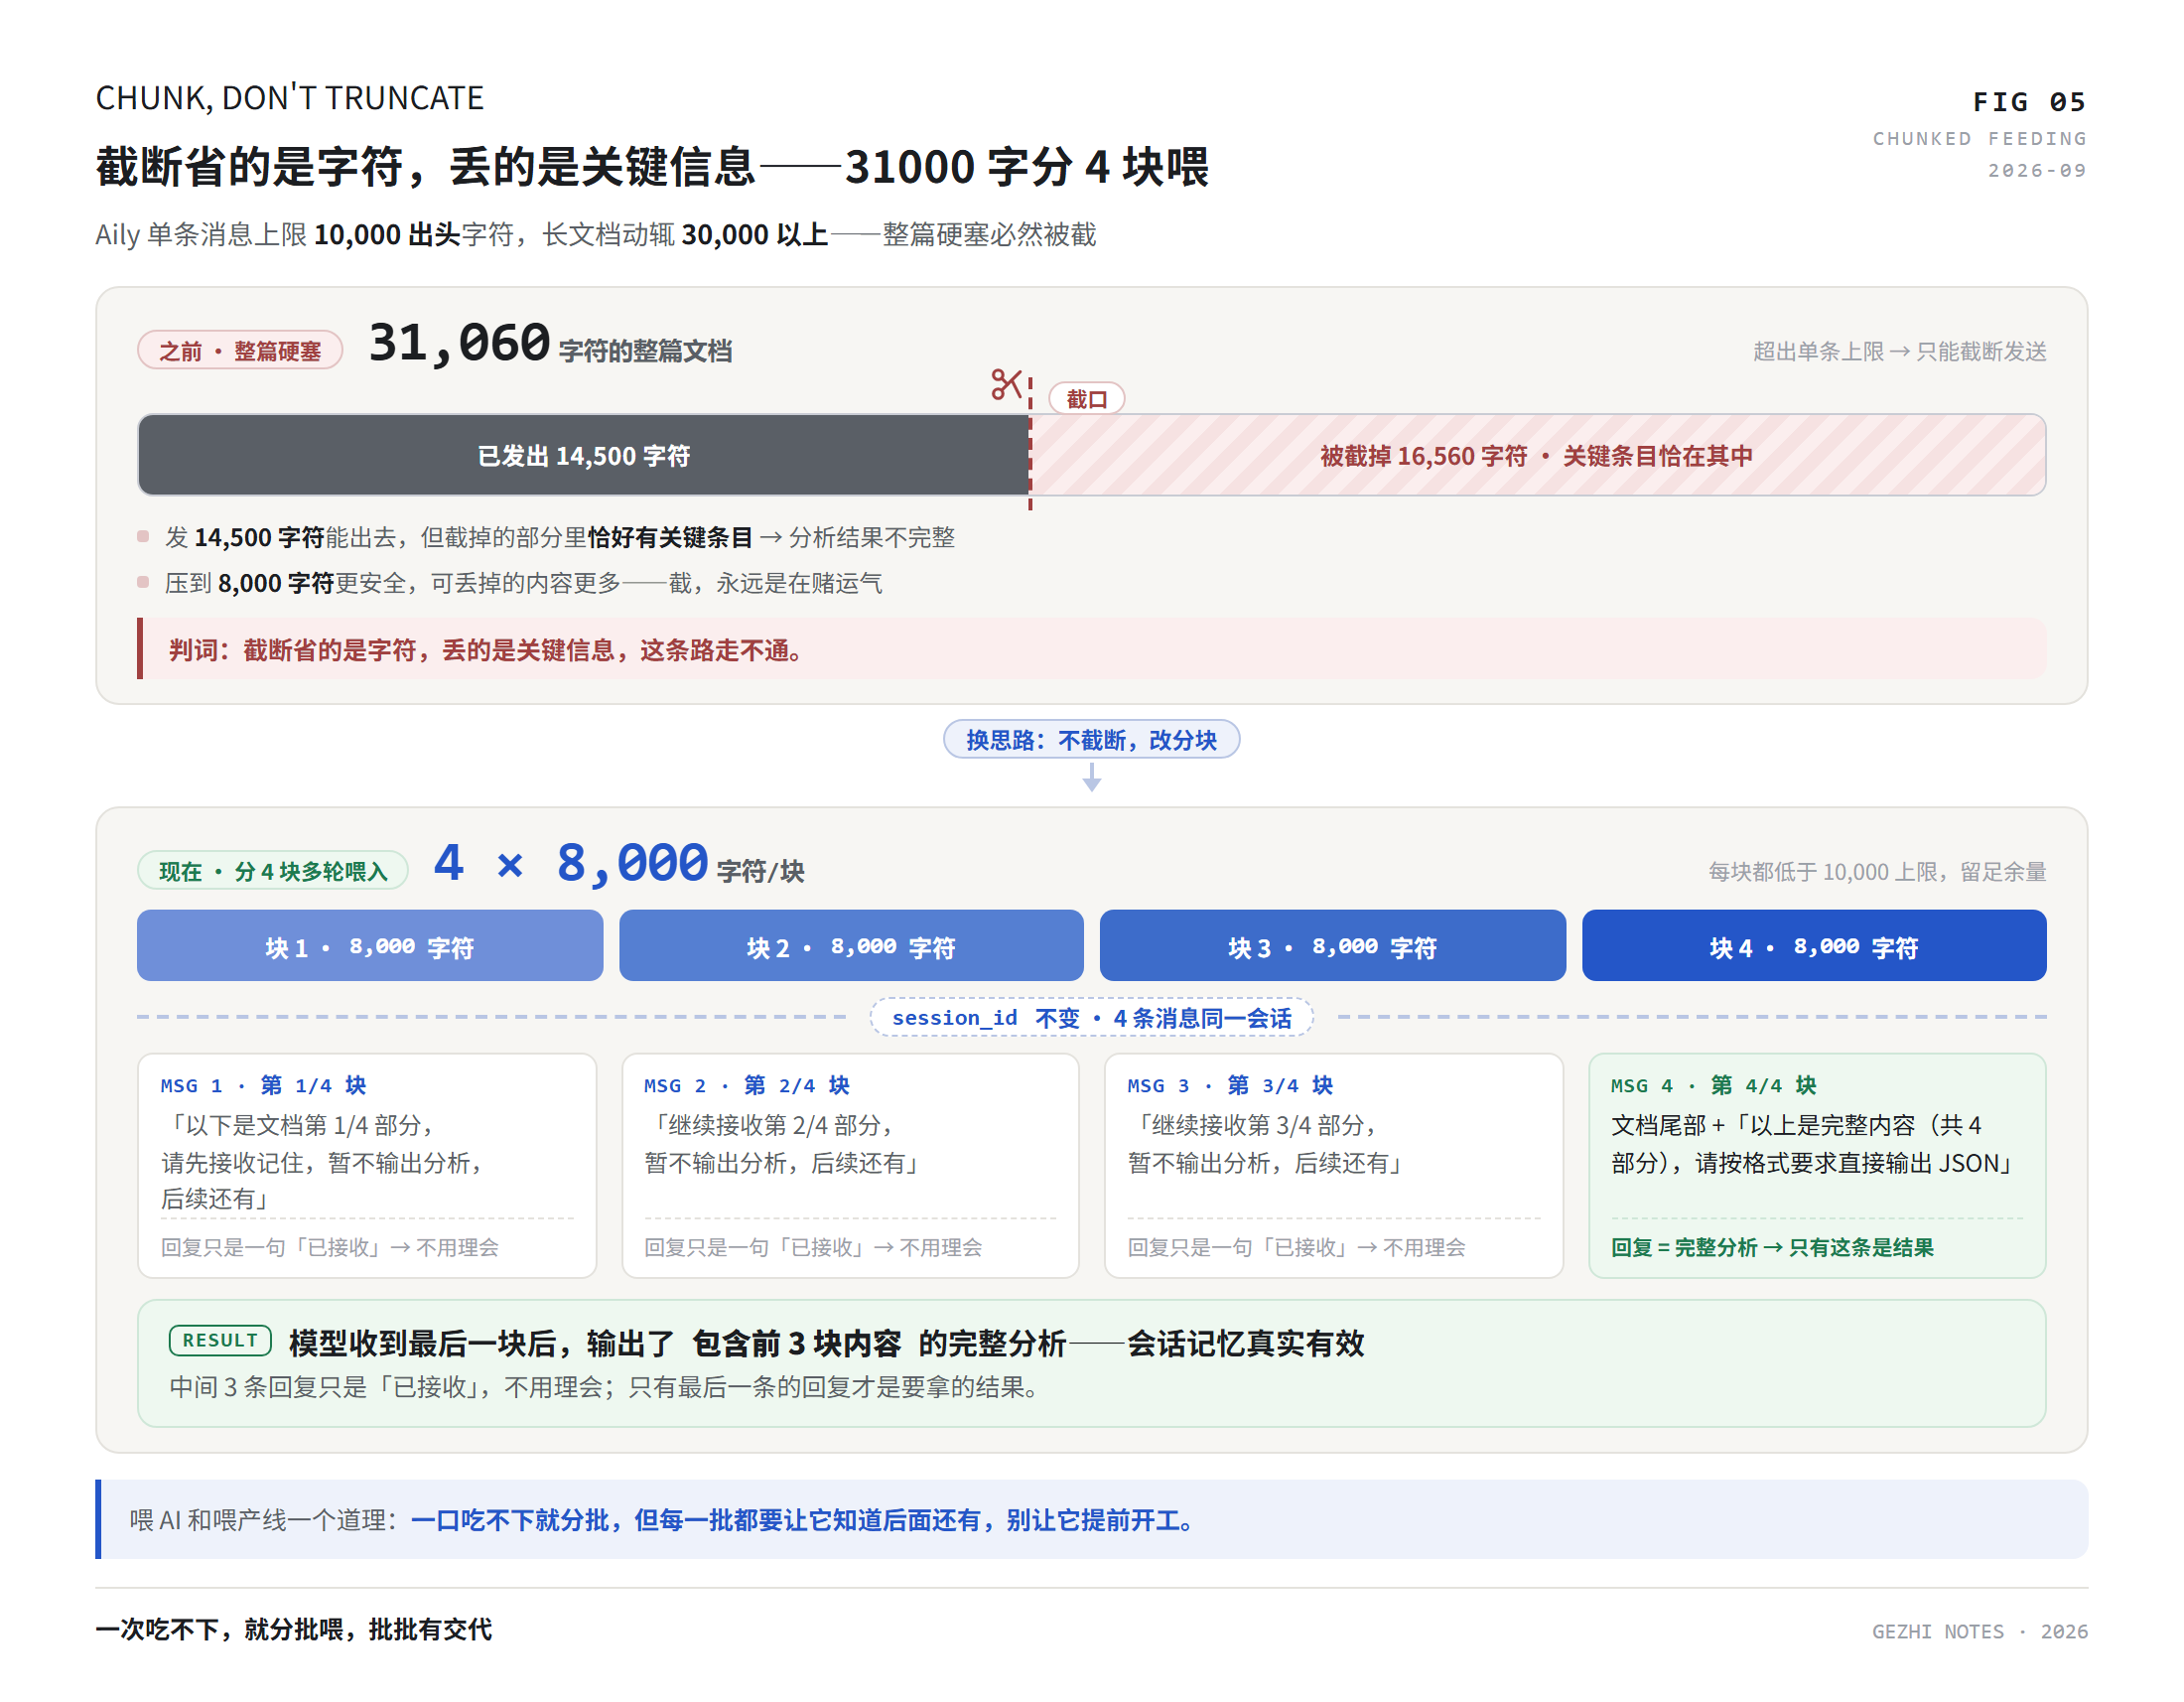
机制上,第 1 块发出时会开启一个会话并拿到会话 ID,后续每块都续在这个会话里——模型就记得前面发过什么。实测 31,060 字符分 4 块,模型在收到最后一块后,输出了包含前 3 块内容的完整分析,会话记忆真实有效。
两个实施细节:一是中间块的回复不用理会——模型对中间块只回一句「已接收」,只有最后一块的回复才是结果;二是最后一块的等待时间要给足,前面各块 2 分钟够用,最后一块给满 5 分钟,因为真正的大活(读完全文+输出 JSON)在它身上。
喂 AI 和喂产线一个道理:一口吃不下就分批,但每一批都要让它知道后面还有,别让它提前开工。
五、生产化:调通靠文档,调稳靠防御
验证环境到生产环境,差距全在防御层,三件套一个不能少:
重试——整个调用包在最多 2 次的自动重试里,网络抖动、偶发限流自己扛过去;超时——每个请求、每次轮询、整条调用链,层层都有超时上限,任何一环挂起都能被掐断重试;清洗——模型回复里混着思考过程和代码块标记,先把噪音洗掉,再从回复中定位 JSON 部分提取,解析不了就走重试。
六、成绩单:三万字文档 90 秒出结果
迁移后实测(网站里走大模型的两类调用):
| 调用类型 | 文档长度 | 模式 | 耗时 | 结果 |
|---|---|---|---|---|
| 长文档分析 | 31,060 字符 | 分 4 块发送 | 93.6 秒 | JSON 正确解析 |
| 短输入分析 | 1,119 字符 | 单次发送 | 41.9 秒 | JSON 正确解析 |
| 整条流程 | — | — | 2 分 35 秒 | 全部通过 |
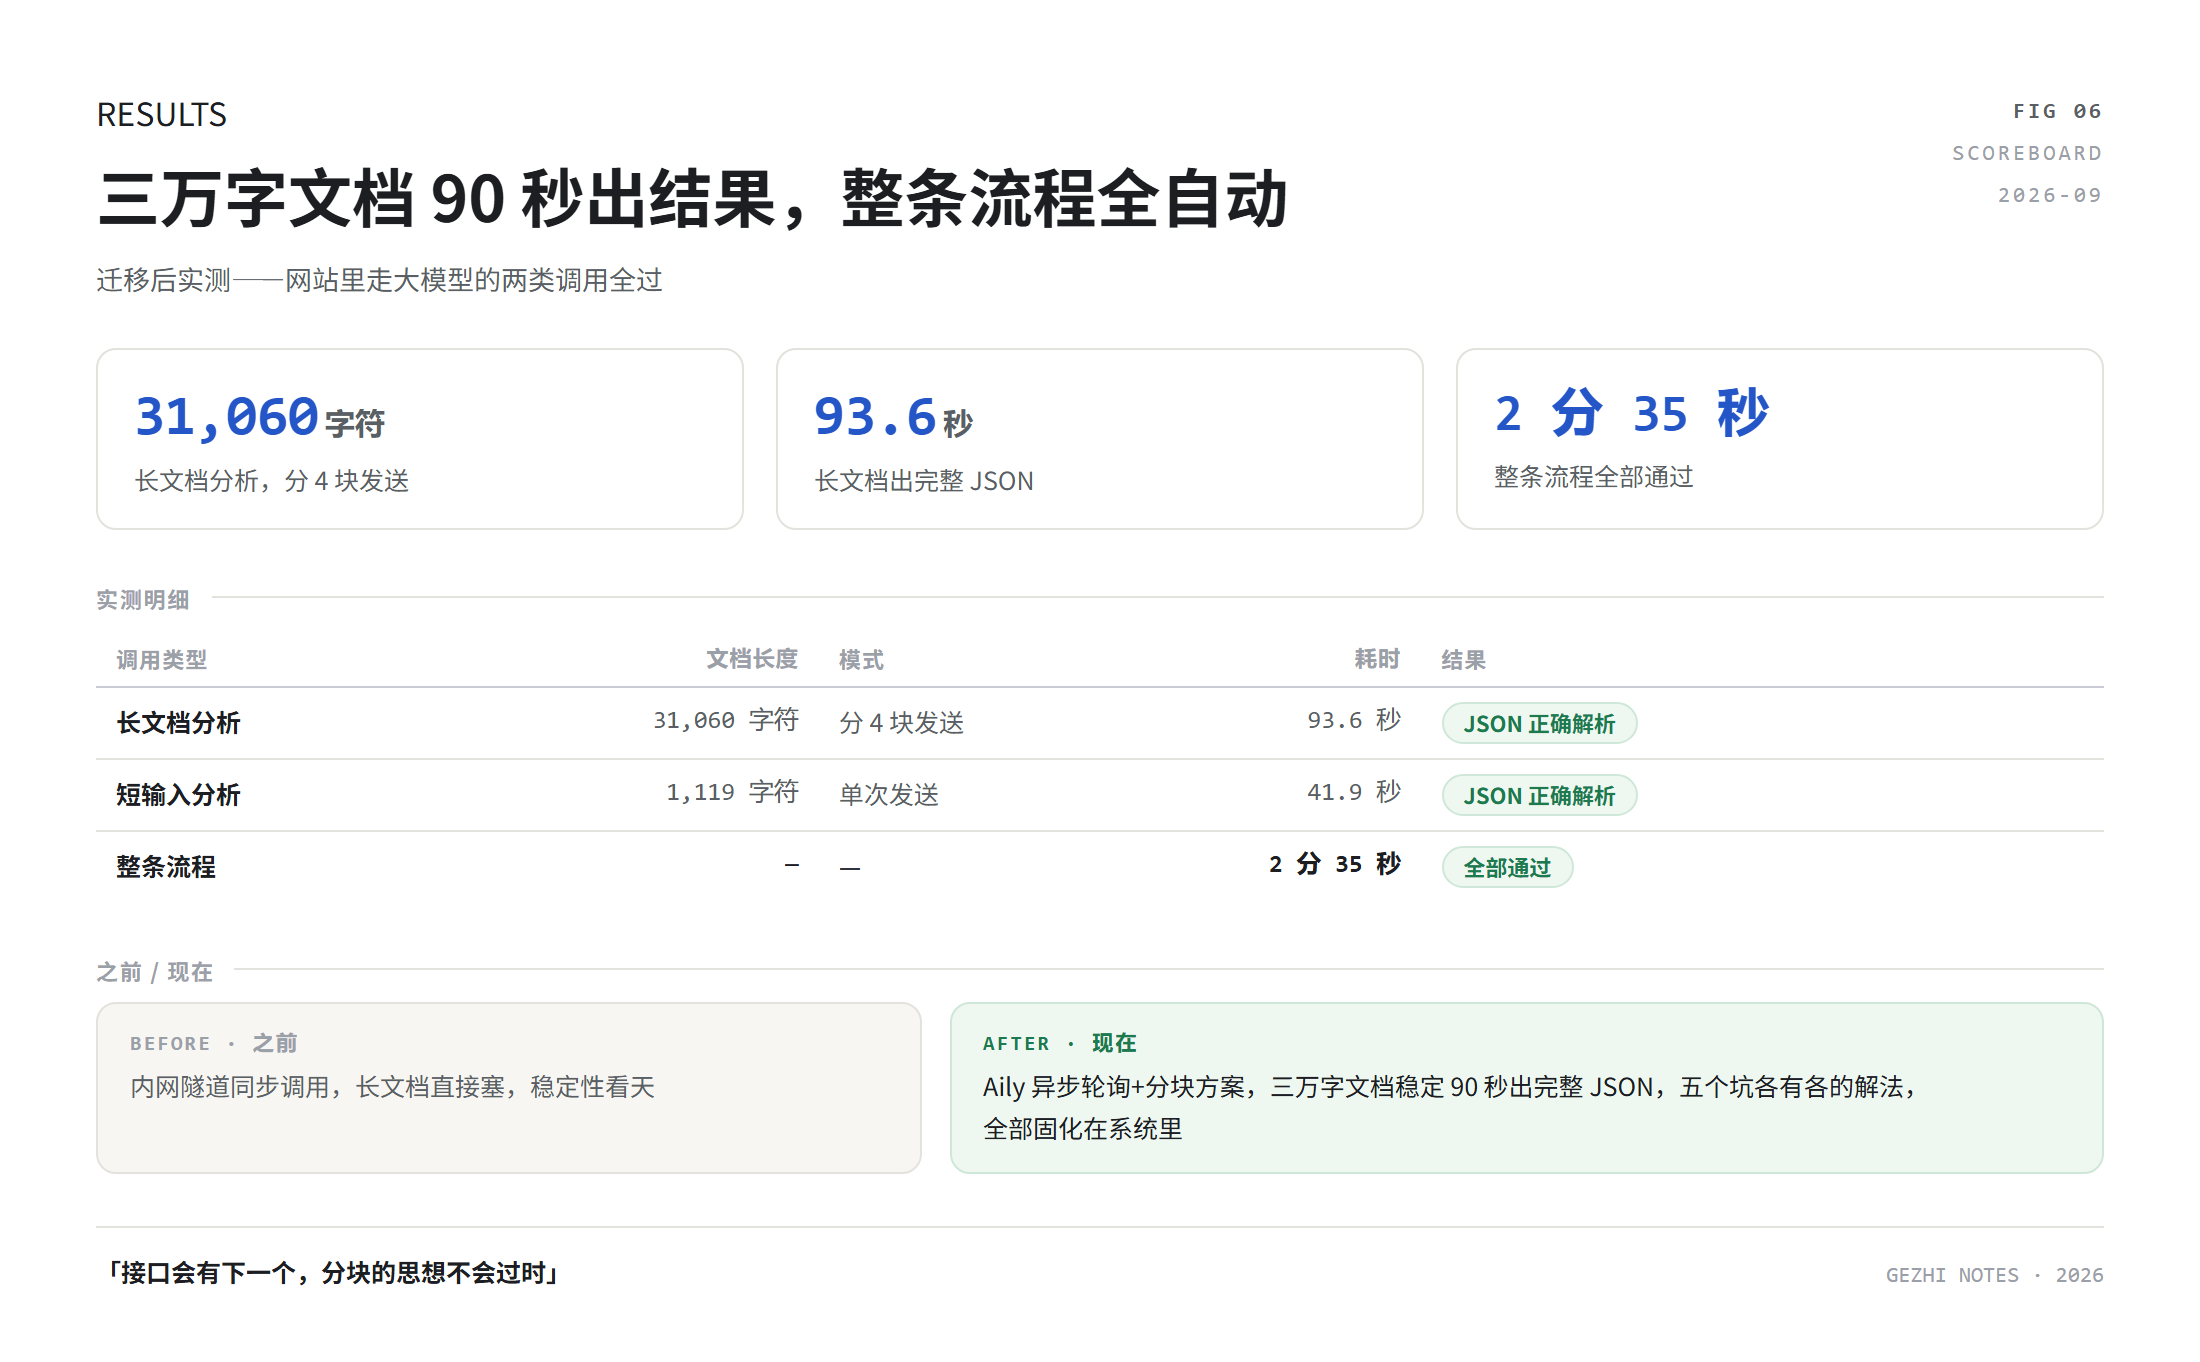
之前: 内网隧道同步调用,长文档直接塞,稳定性看天;现在: Aily 异步轮询+分块方案,三万字文档稳定 90 秒出完整 JSON,五个坑各有各的解法,全部固化在系统里。
七、收尾
企业环境的约束不会跟你商量:模型 API 只放行一个,消息长度只给一万,调用模式只开异步。抱怨约束没有用,把约束一条条翻出来、配上解法,才是工程师该干的事。
三条留给要做同样集成的人:应用密钥只活在服务端环境变量里;令牌缓存复用,别把每次调用都变成两次;用户身份和大模型调用是两套鉴权,永远别混。
接口会有下一个,分块的思想不会过时:一次吃不下,就分批喂,批批有交代。