STUDIO · SPEC SHEET · UNIT S32
AI 干活干到一半失忆:我给它上了一套交接班制度
——一套把制造业交接班制度搬给 AI 长任务的实录
现在我把越来越多的长任务交给 AI:批量同步几万条物料记录、部署一次站点发布、跑一轮数据质量报告——一个任务经常跑一两个小时,几十轮对话。AI 的能力是够的,问题出在它会「失忆」。
痛点1:长任务跑到后半段,前半段的活重干一遍。 不止一次,看着它把八步任务干到第七步,忽然回头把第二步又执行了一遍——已经同步过的数据重新同步,已经修好的校验规则重新推翻。问它为什么,它答得理直气壮,因为它真的不记得自己干过。
痛点2:纠正过的错误,隔十几轮又原样犯一遍。 明明说过「这个字段必须模糊匹配」,聊到后面它又改回精确匹配。它不是不服,是真的不记得你说过这句话。
痛点3:任务中途被打断,新会话完全不知情。 一个批量任务跑了二十多分钟,平台一重启,进度说没就没。新开会话说「继续刚才的任务」,它一脸茫然:什么任务?
一、根因:平台不是压缩记录,是撕记录
查了机制才明白:我们用的智能体平台(飞书 Aily),上下文管理是截断机制——上下文窗口装不下了,把最早的消息直接移除。注意,不是压缩:压缩是把旧记录总结成摘要留个底,截断是最早的那几页纸直接从工作台上消失。
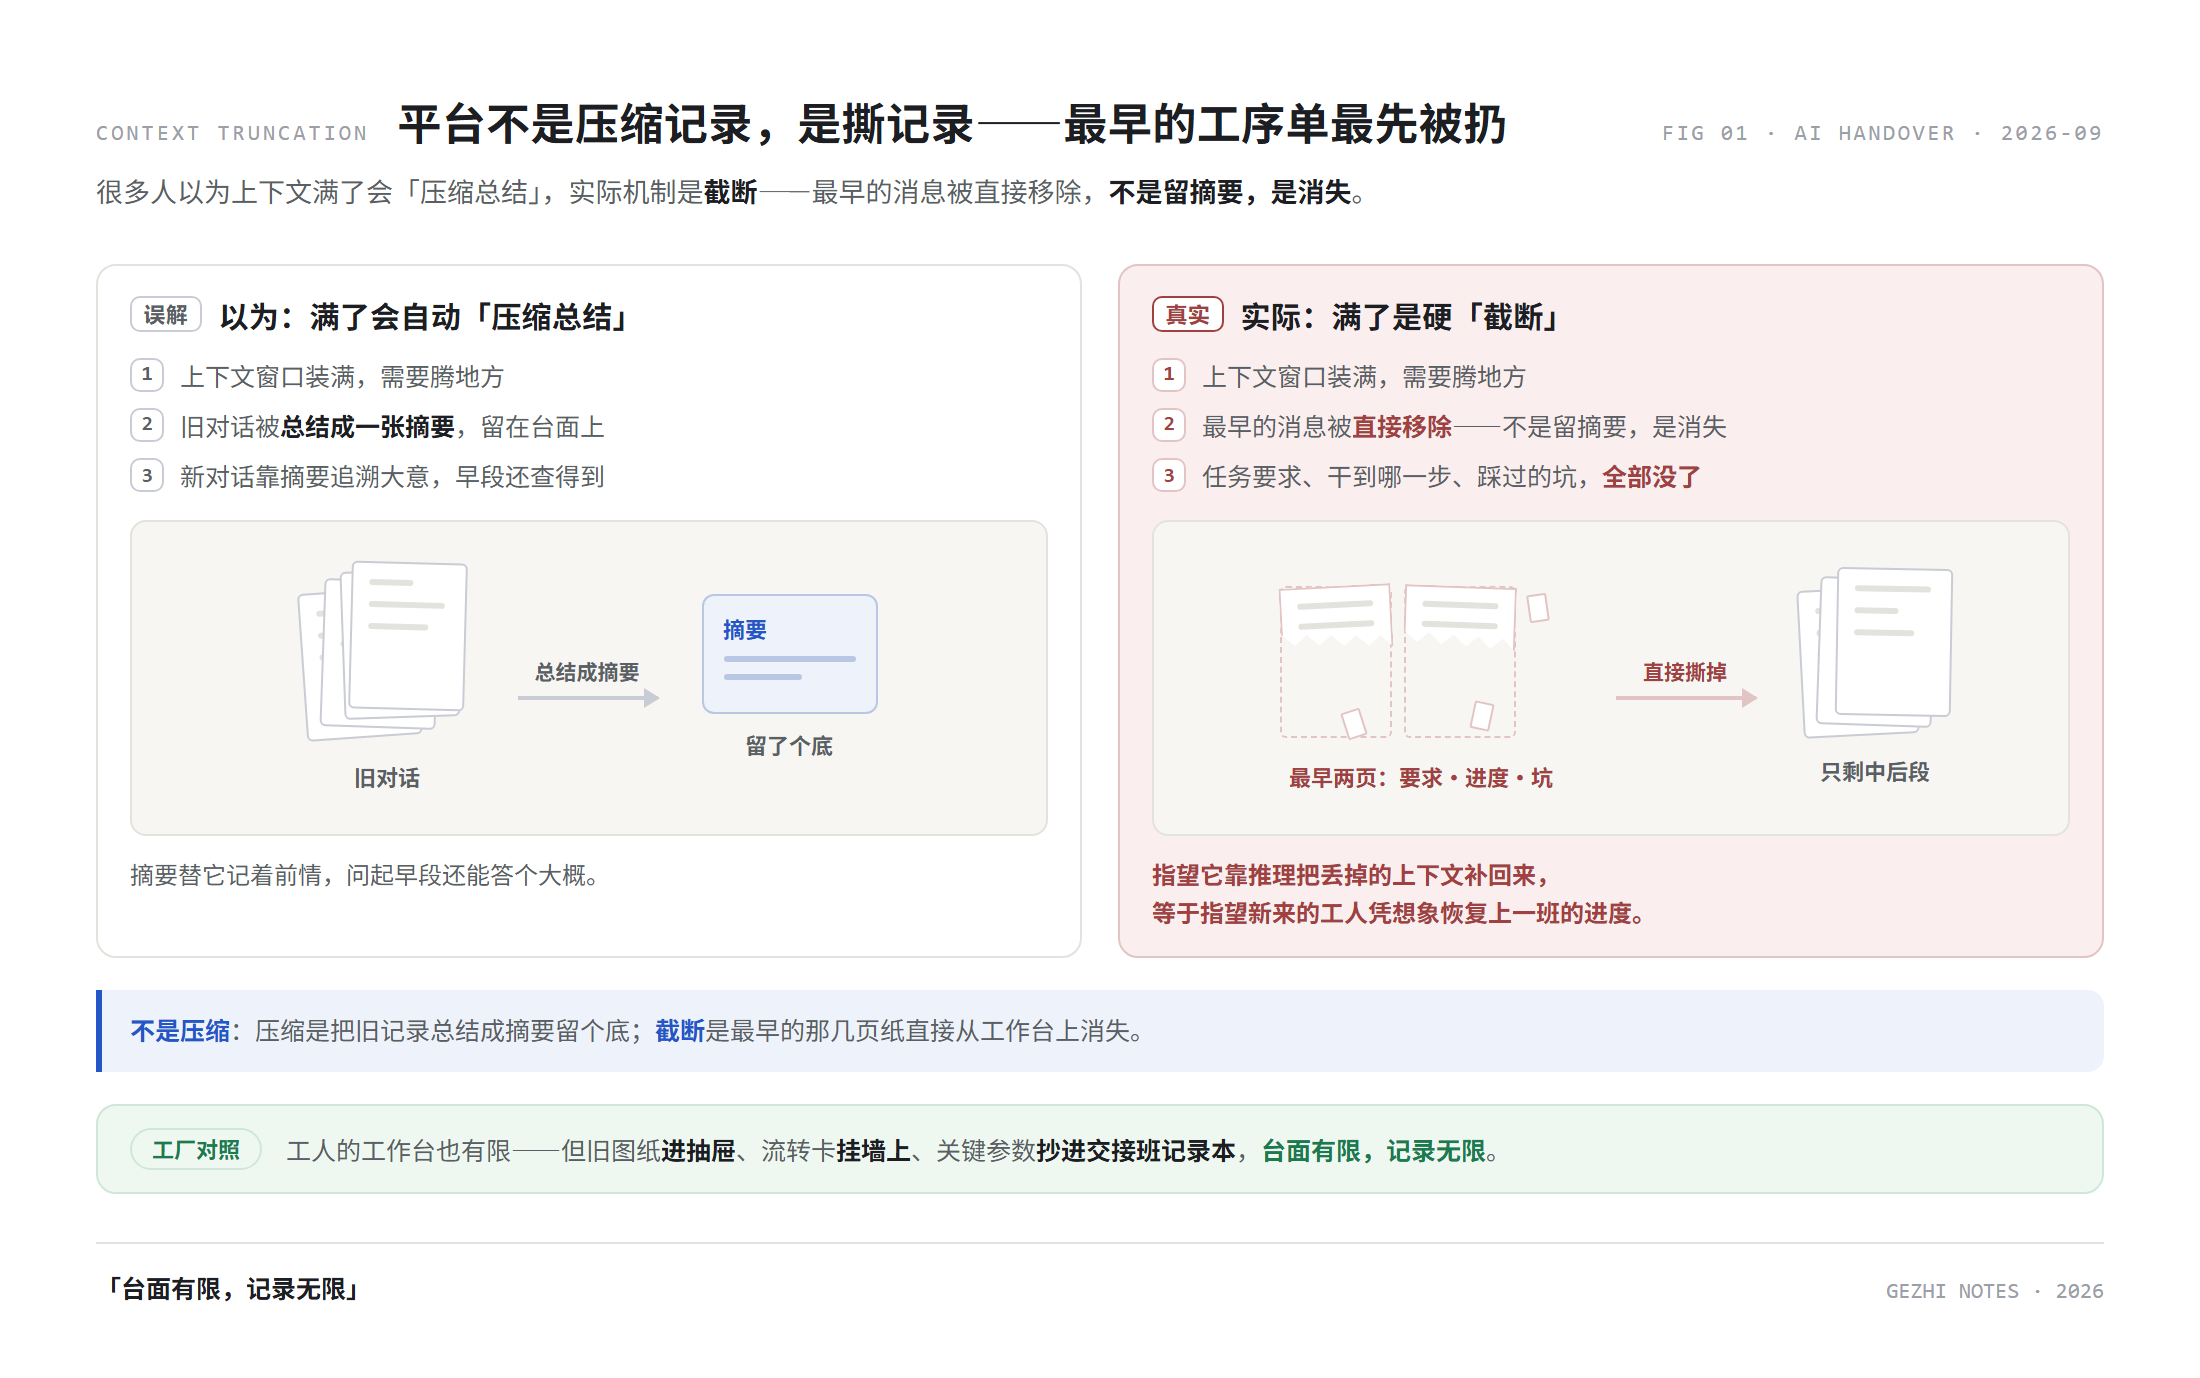
这跟工厂完全是两回事。工人的工作台也就这么大,新图纸不断铺上来,但工厂的做法是:旧图纸进抽屉、流转卡挂墙上、关键参数抄在交接班记录本上——台面有限,记录无限。而平台的做法是:台面满了,先撕最早的那几张。
所以 AI 跑长任务失忆,不是模型变笨了,是工序单被撕了。它手里只剩后半段的对话,前半段的任务要求、干到哪一步、踩过什么坑,全都不在了。指望它靠「推理」把丢掉的上下文补回来,等于指望新来的工人凭想象恢复上一班的进度。
二、方案:把工厂最老一套的制度,搬给 AI
解法不是更玄的提示词,是制造业最老生常谈的那套东西——交接班制度。工厂从不相信任何人的记性,只相信记录:任务书、流转卡、交接班本、仓库台账。我把这套东西翻译成六个文件:
| 制度原型 | 文件 | 作用 |
|---|---|---|
| 生产任务书+变更单 | TASK_PLAN.md | 原始要求一经写入只读;需求变化只追加,永不改写原话 |
| 工序流转卡 | TASK_PROGRESS.json | 任务状态唯一事实源,其余文件都是它的视图 |
| 交接班记录本 | TASK_HANDOVER.md | 每步五段式:意图/决策/文件/错误/下一步 |
| 仓库台账 | TASK_INDEX.md | 大产物的索引:一句话摘要+文件路径 |
| 生产日志 | SESSION_LOG.md | 每轮增量检查,有新事实才写,寒暄轮零写盘 |
| 当前状态简报 | SESSION_SUMMARY.md | 滚动摘要,新会话第一眼就看它 |
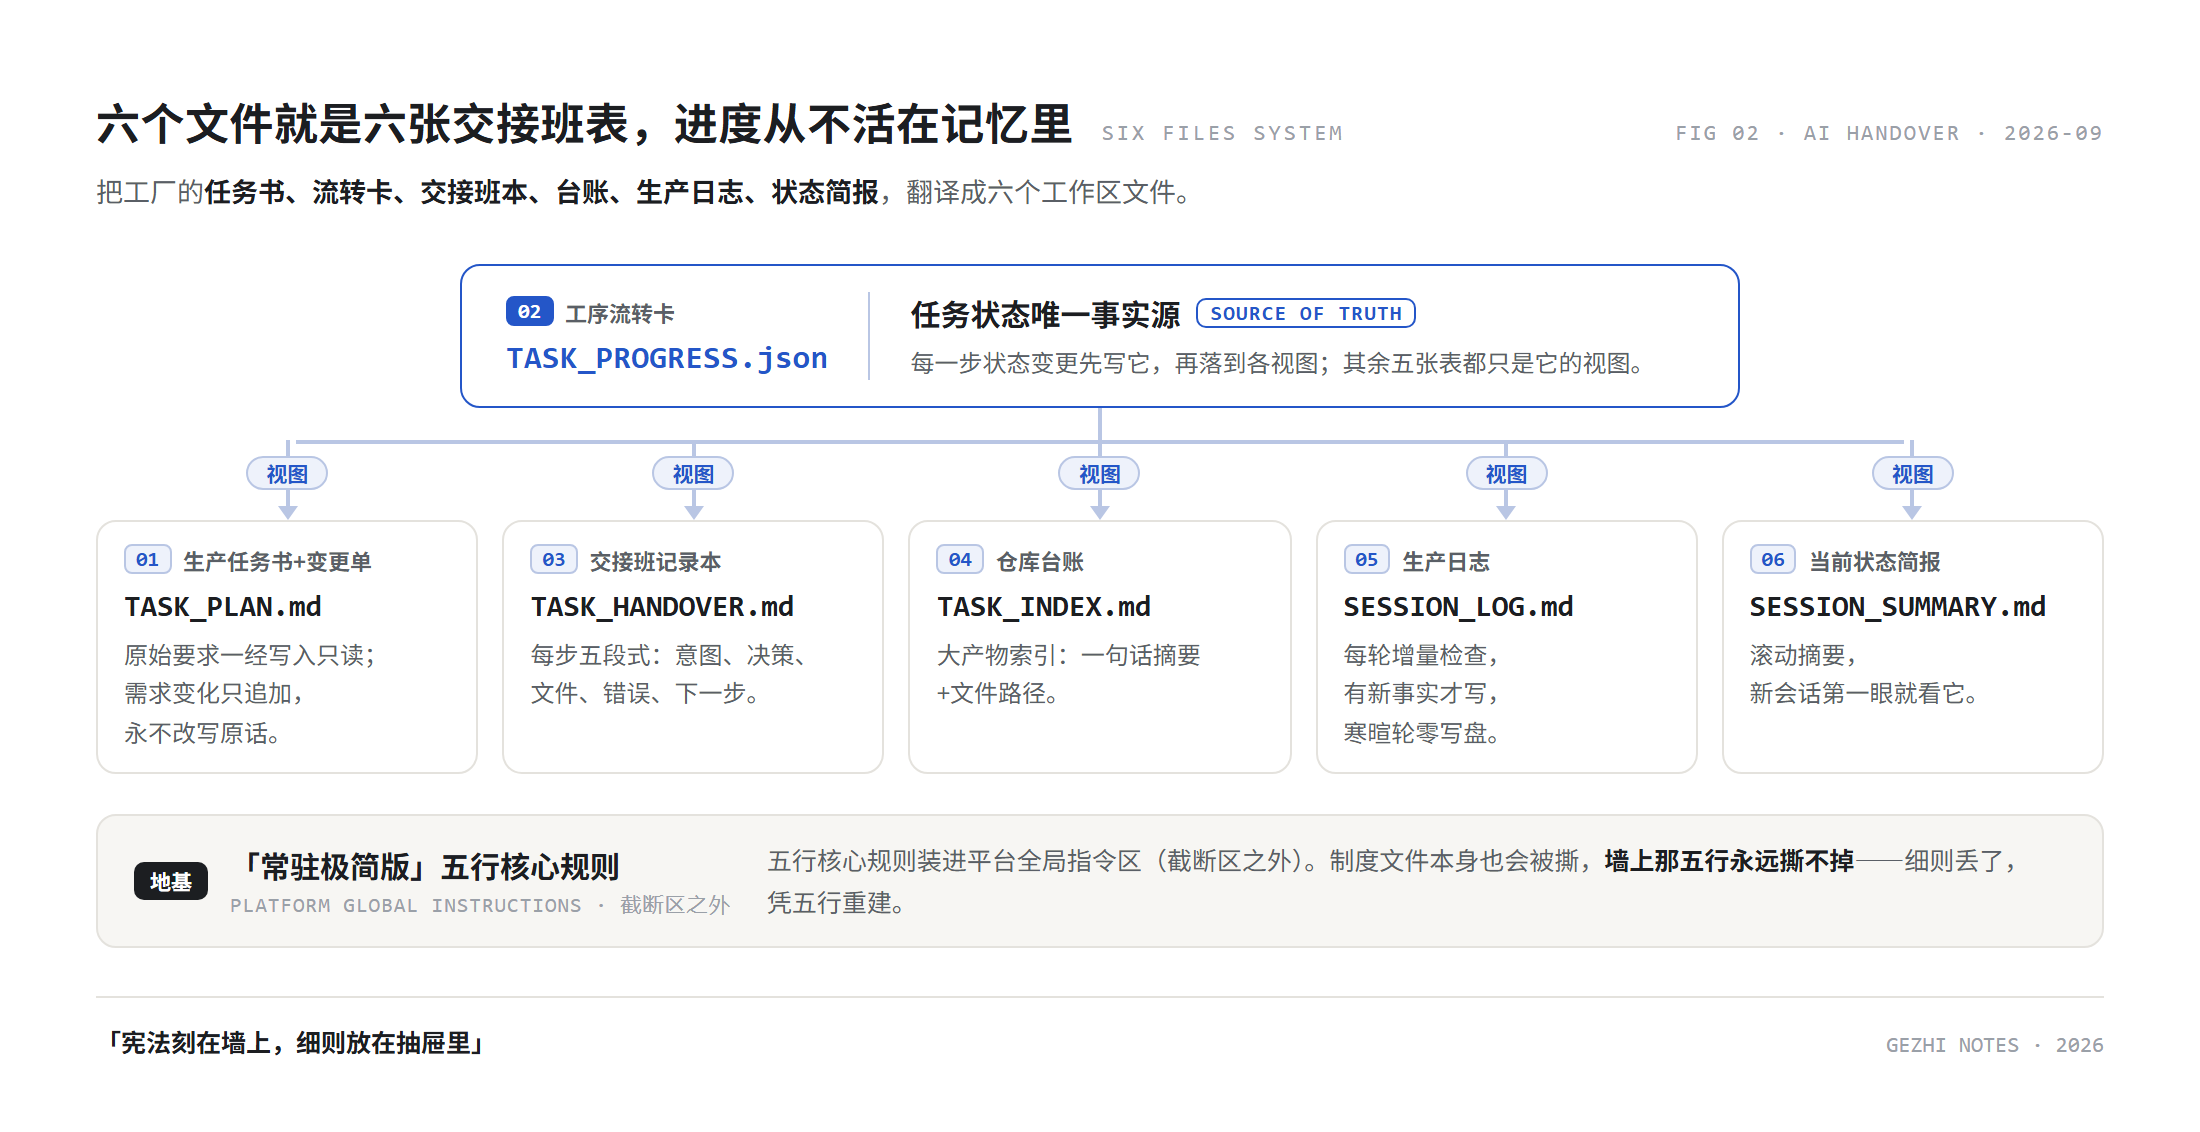
还有一条地基级的补充:这份制度文件本身也活在工作台上,也一样会被撕。所以制度的第一节是一个「常驻极简版」——五行核心规则,要求装进平台的全局指令区(截断区之外)。宪法刻在墙上,细则放在抽屉里:墙上那五行永远撕不掉,细则丢了也能凭五行重建。
三、唯一事实源:没有证据,就没有 done
流转卡(TASK_PROGRESS.json)是整个制度的核心,规则就一句:每完成一步,立即写卡,done 必须带证据。
之前:问 AI「这步做完了吗」,它说「做完了」——依据的是手里残缺的记忆;打开目录一看,文件根本不存在。
现在:恢复会话第一件事读流转卡,每个 done 的步骤后面必须跟着一行证据——跑了什么命令、输出是什么、产物在哪个路径。「我觉得做完了」不算数,「命令 X 输出 Y」才算数。
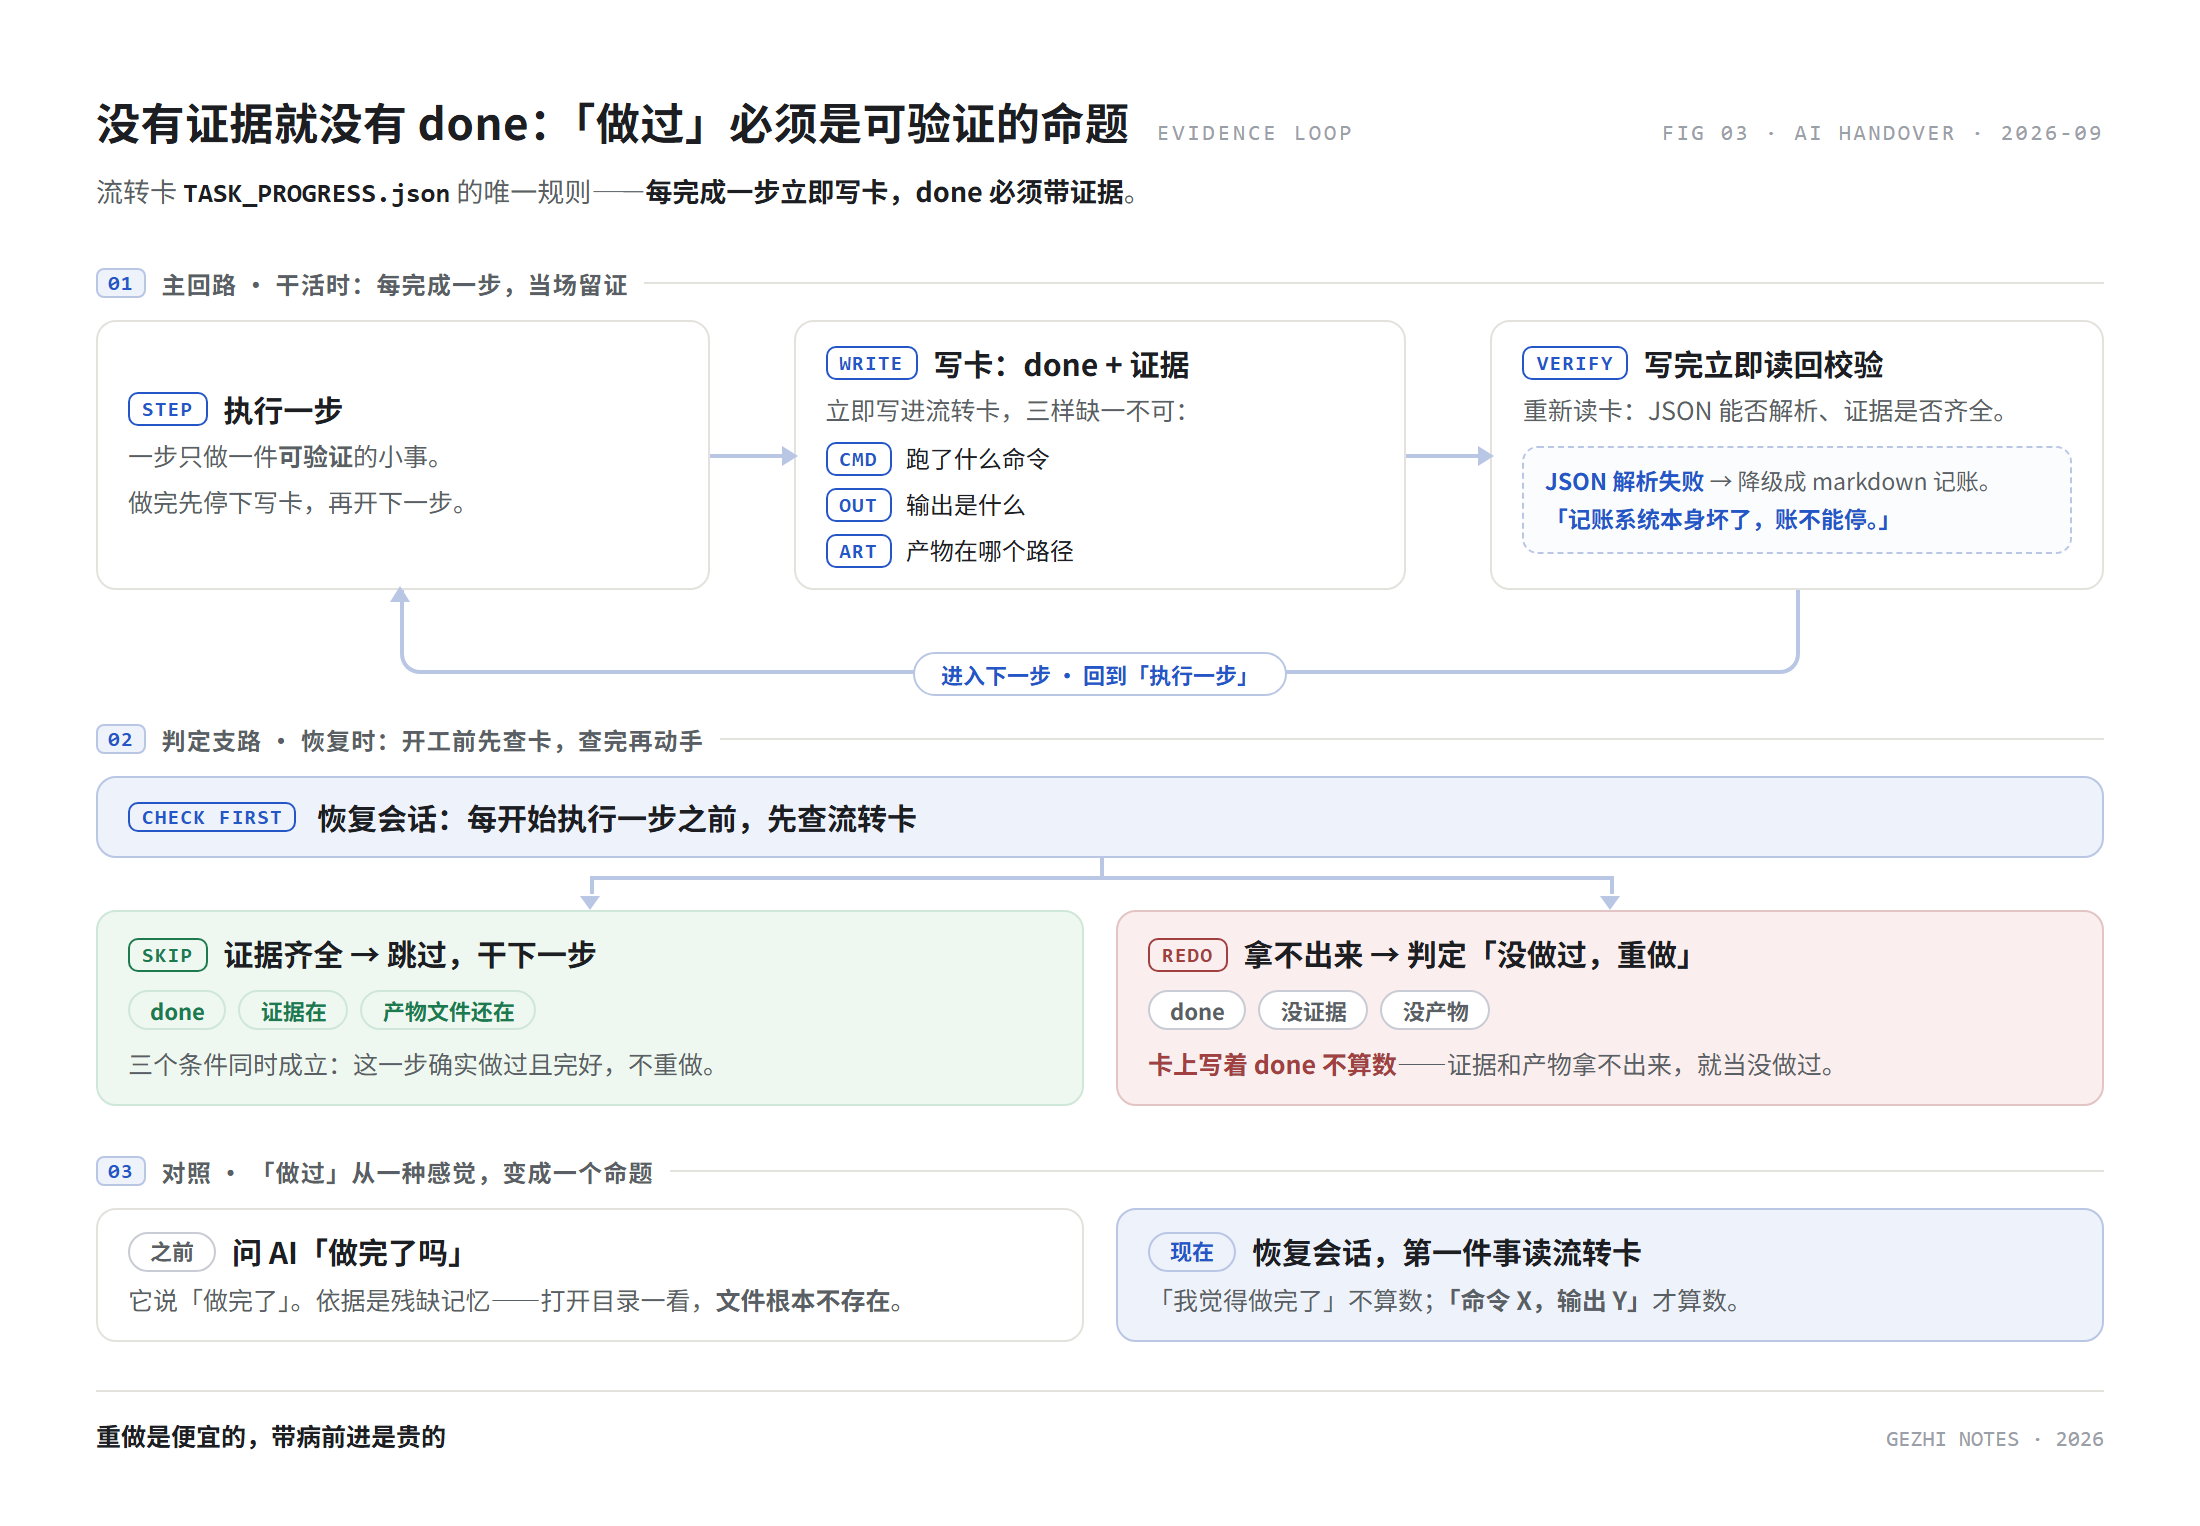
配套一条反重复检查:每开始执行一步之前,先查流转卡——这步标了 done、证据在、产物文件还在?跳过,干下一步。done 但没证据、没产物 = 没做过,重做。 重做是便宜的,带病前进是贵的。
流转卡自己也不能成为故障点:每次写完立即读回校验一次,JSON 解析失败就降级成 markdown 记账。记账系统本身坏了,账不能停。
四、每步即时写盘:流转卡是每道工序签一次章
这条是制度迭代到第三版(v2.2)才补上的,也是现实里最疼的一课。
前两版写的是「每轮对话结束时更新进度」。听起来合理,实际一用就翻车:批量任务跑到一半平台重启,那一轮还没「结束」,进度一行都没落盘——新会话对着空白的流转卡,等于任务从没发生过。
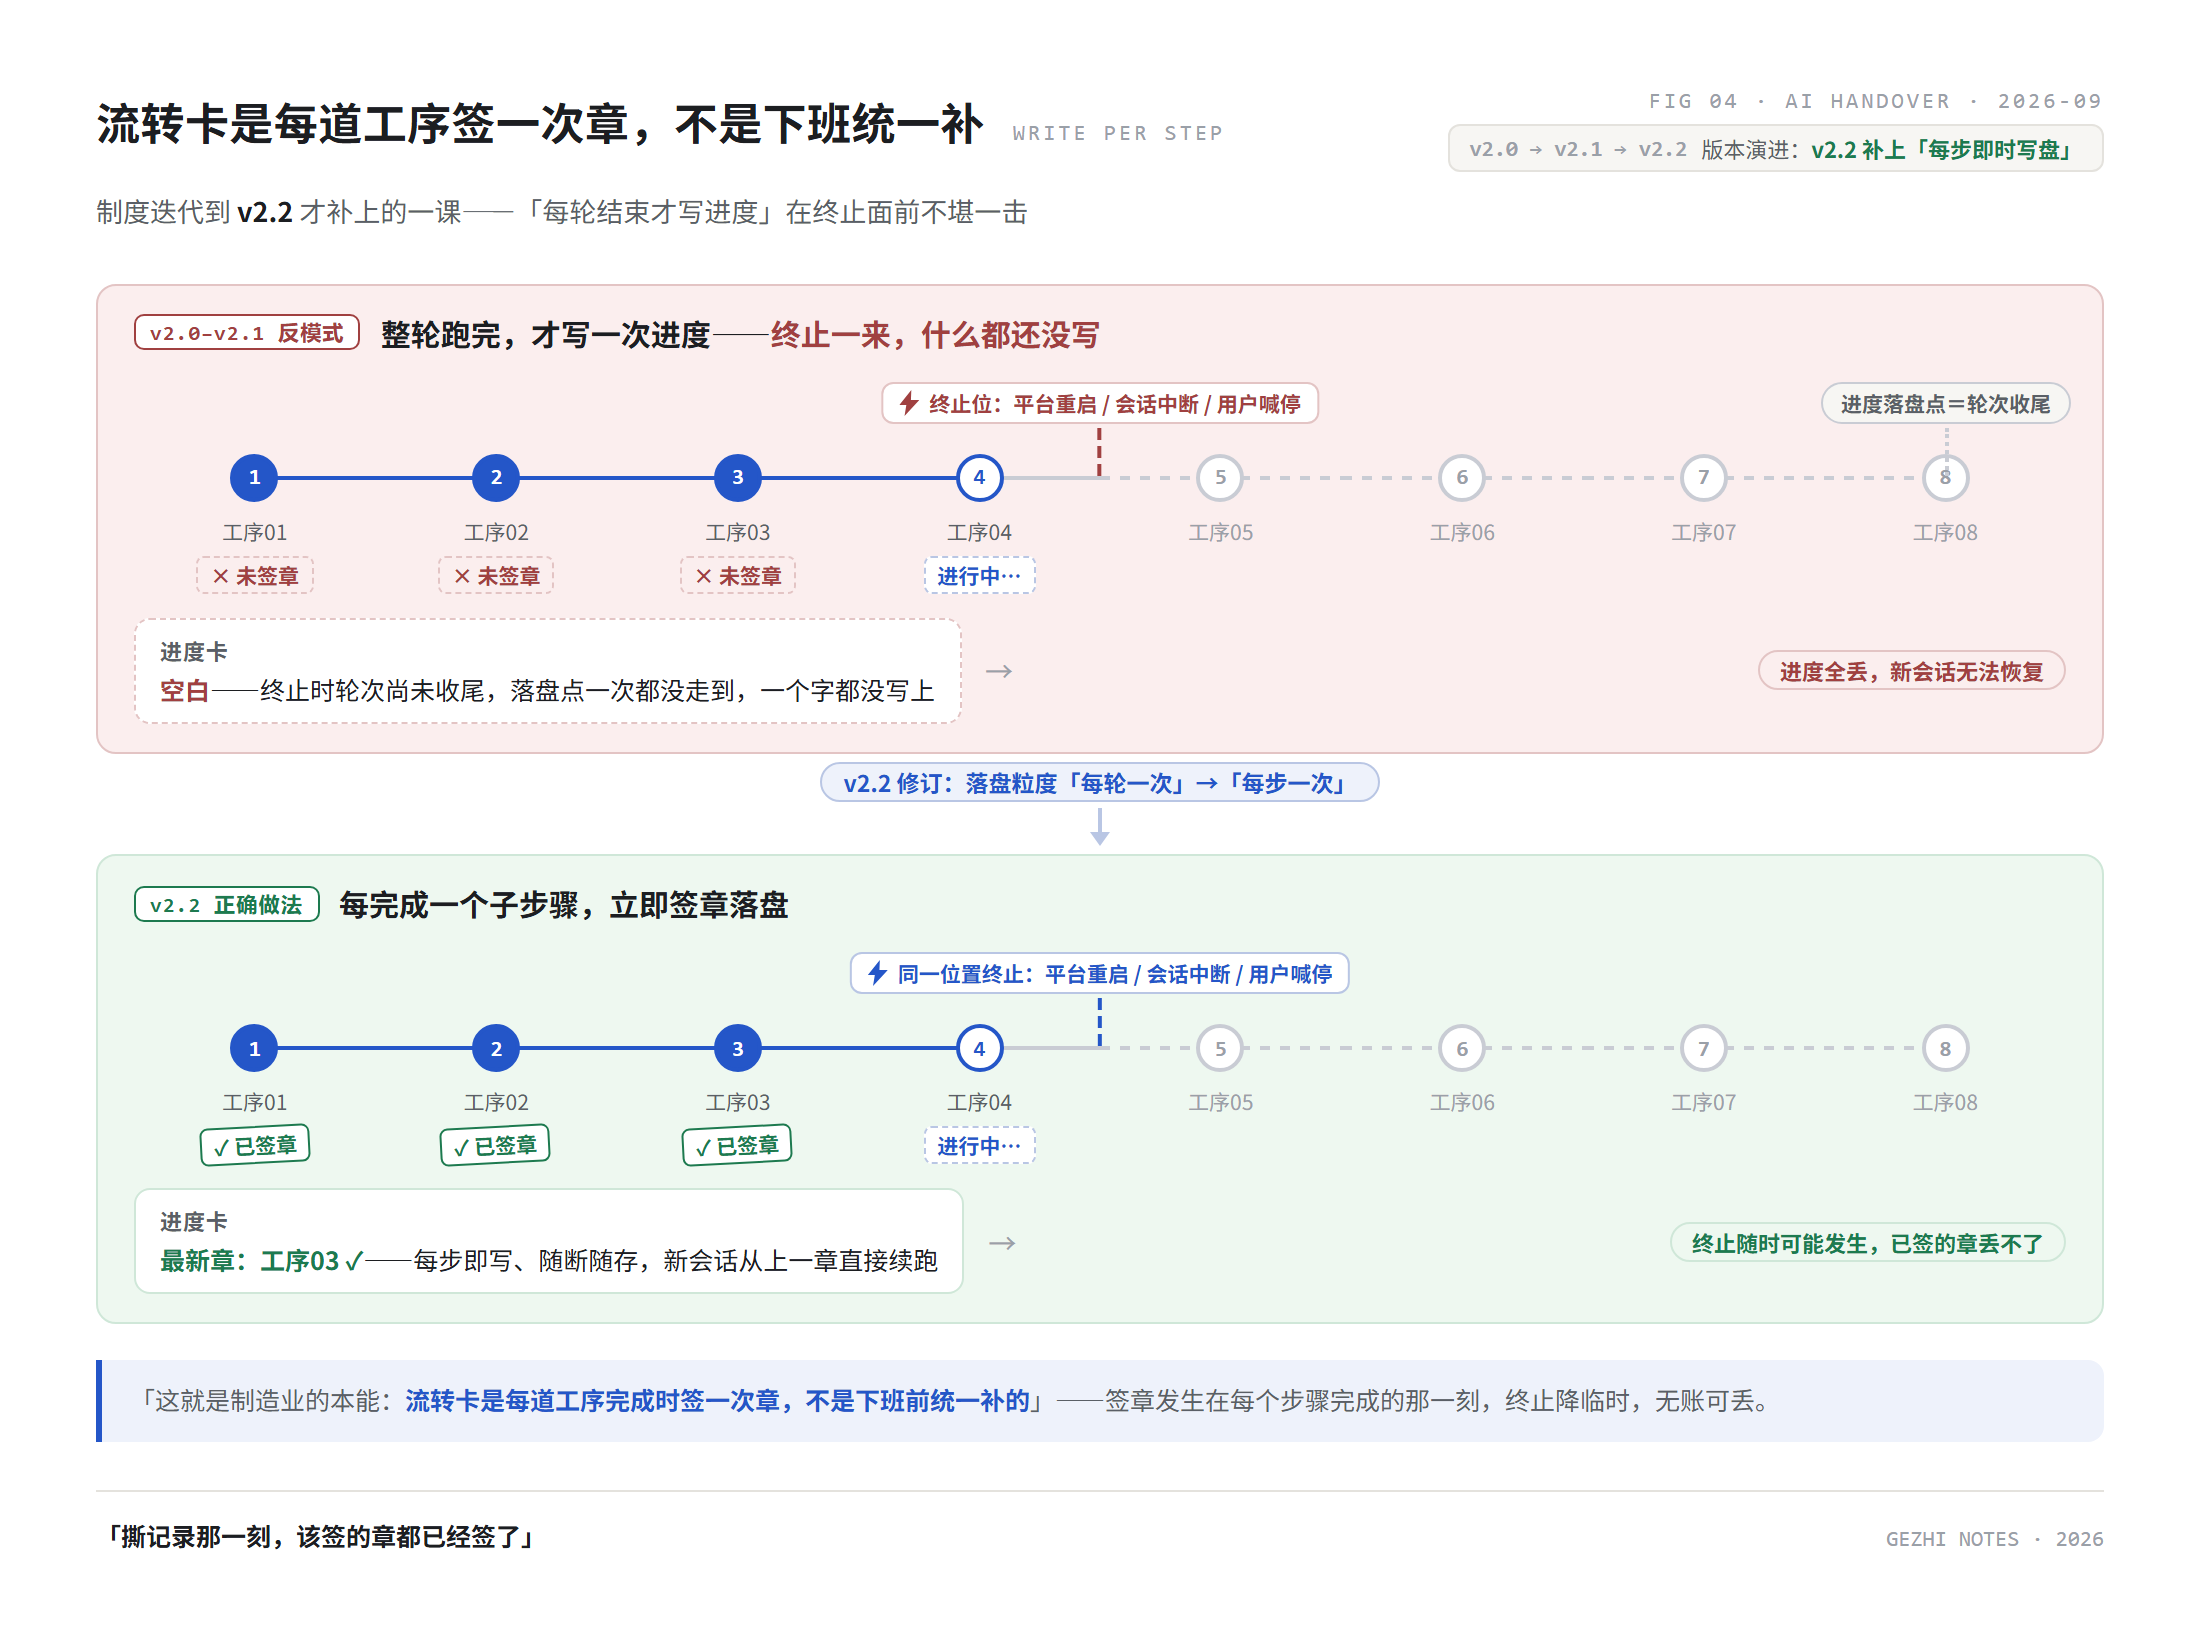
之前: 轮次结束才写进度 → 中途被终止 → 进度全丢 → 新会话无法恢复。
现在: 每完成一个子步骤,立即写盘。终止随时可能发生——平台重启、会话中断、用户主动喊停——唯一靠得住的是撕记录那一刻,流转卡上该签的章都已经签了。
这就是制造业的本能:流转卡是每道工序完成时签一次章,不是下班前统一补的。这么自然的一件事,我却让这套制度迭代了两版才翻译过去。
五、分层恢复:接班的人先读交接条,要细节才翻图纸
新会话接班,不能把整个抽屉倒进脑子里——恢复动作本身就会把上下文塞爆,等于刚接班就把自己的工作台铺满。所以恢复分三层,每层带预算:
- L1 必读:状态简报+流转卡+最后 3 条日志,合计控制在约 2000 字内——相当于接班先读上一班的交接条;
- L2 按需:当前步骤 ±1 的交接记录段落——要动手了才翻对应的图纸;
- L3 按需:按台账索引取归档文件,最多取 3 个,用完即止——要查原始数据才进仓。
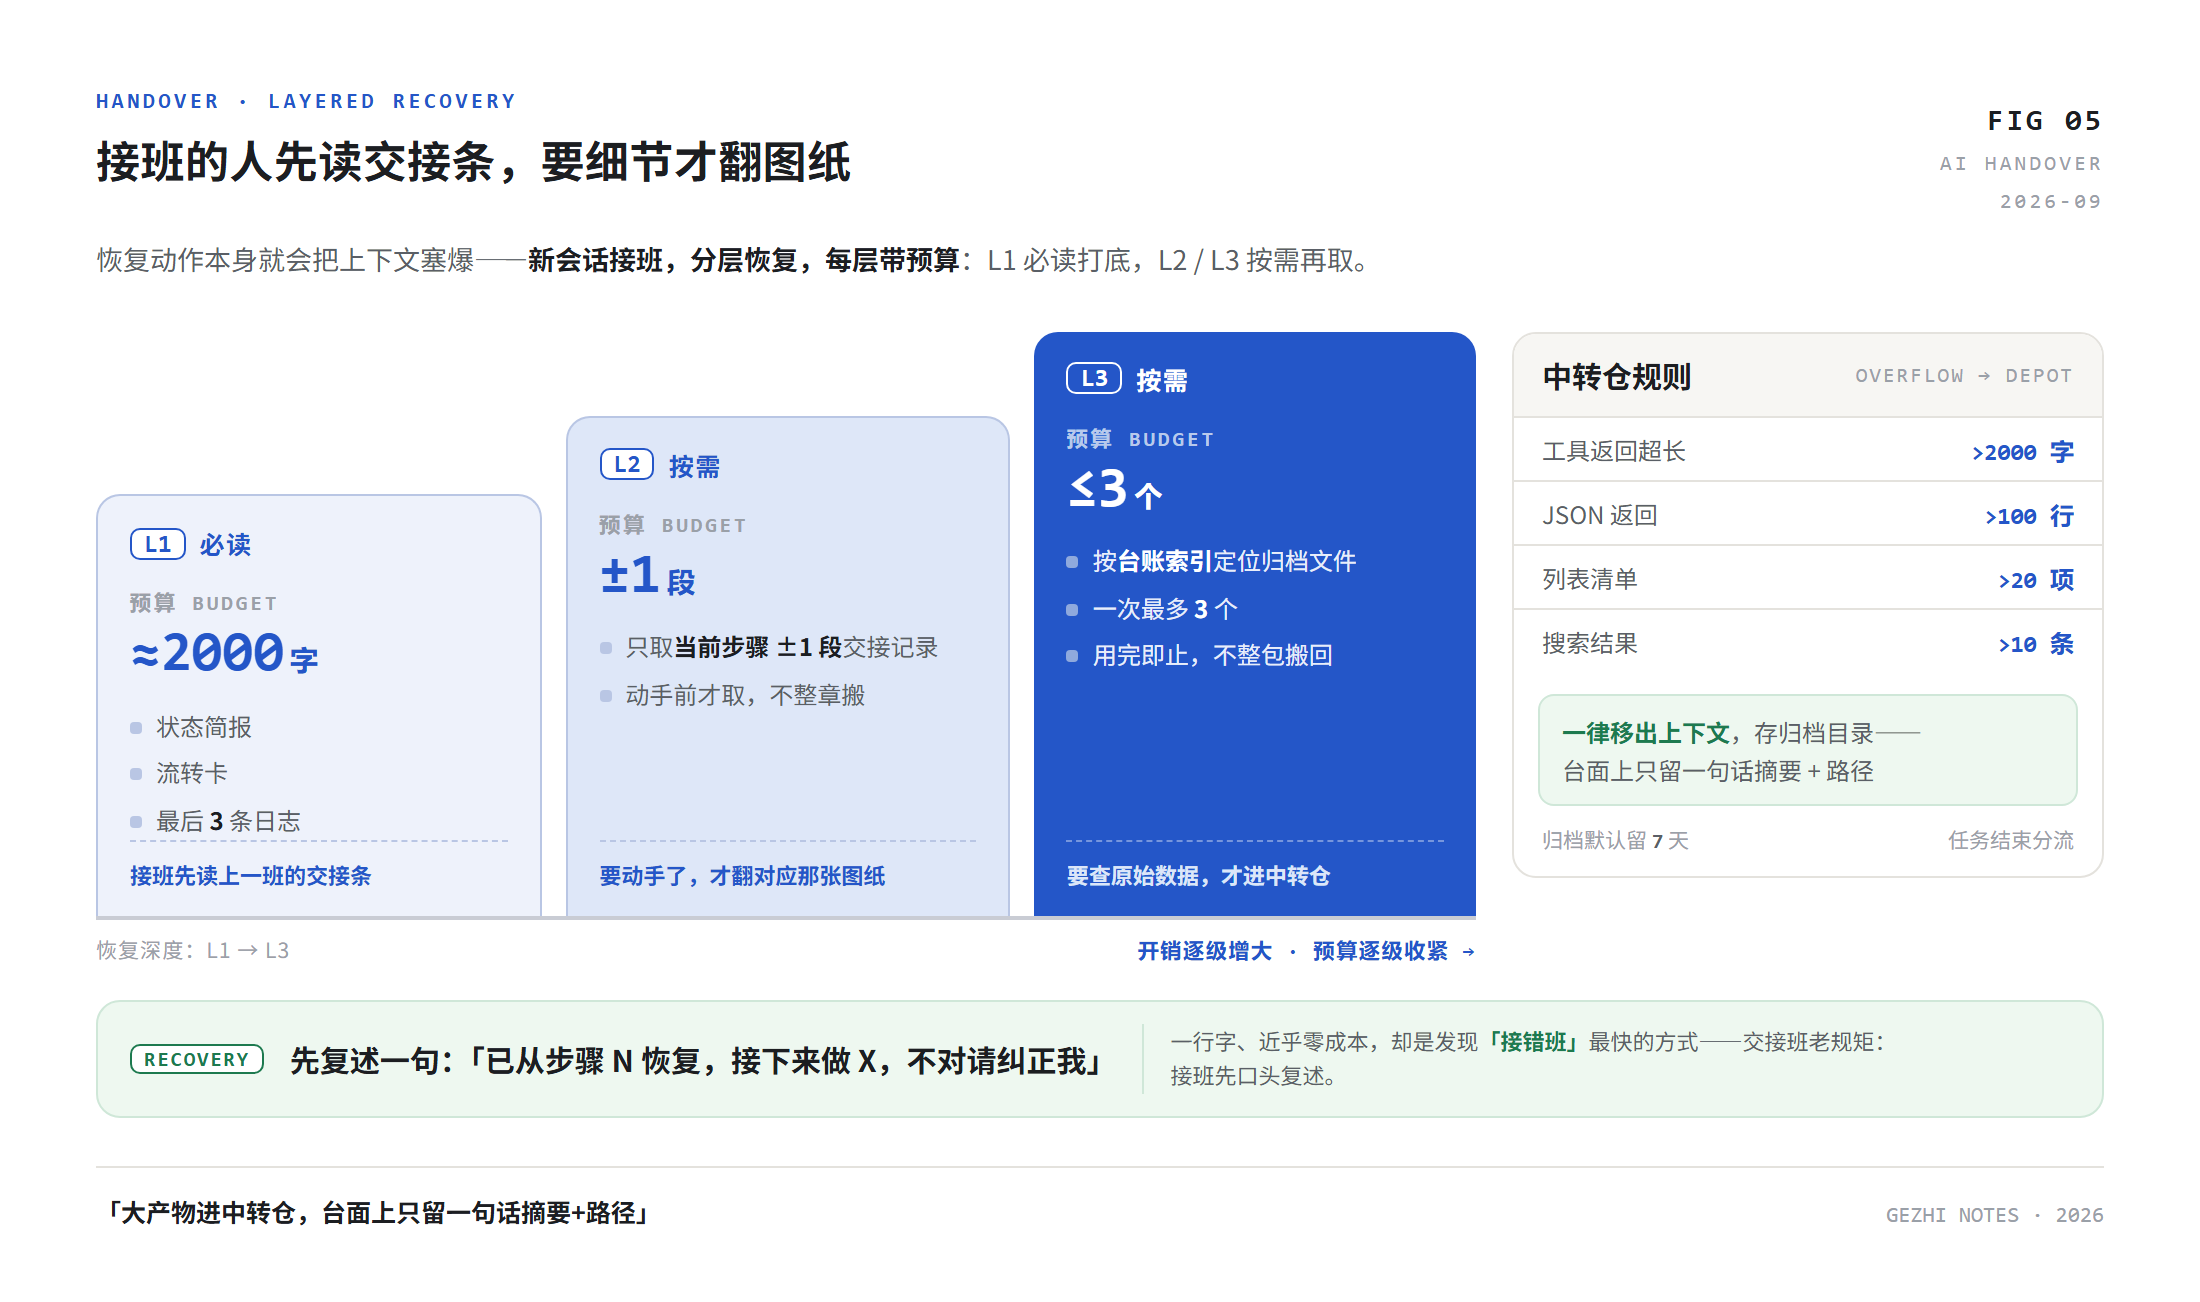
恢复完必须向用户确认一句:「已从步骤 N 恢复,接下来做 X,不对请纠正我。」一行字、近乎零成本,却是发现「接错班」最快的方式——这一样是从交接班制度里抄来的:接班要先口头复述。
大产物进中转仓:工具返回超过 2000 字、JSON 超过 100 行、列表超过 20 项、搜索结果超过 10 条,一律移出上下文、存进归档目录,台面上只留一句话摘要+路径。归档默认留 7 天,任务结束时分流——还要用的移走注明去向,其余删掉,不让中转仓变垃圾场。
六、评价:它治的是失忆,不是糊涂
坦诚说这套制度的边界和踩过的坑:
- 纪律靠自觉,没有强制闸门。 它是一套规则,不是一道门禁——没有「不写卡就不许执行下一步」的硬拦截,AI 偶尔还是会漏签。靠墙上那五行常驻规则反复强化,执行率很高,但不是 100%。
- 对短任务偏重。 三五步的小活配六文件是高射炮打蚊子,所以触发阈值定在「预计超过 3 步」,短任务不开制度、只留简报。
- 迭代了三版才像样。 v2.0 每轮必写日志,日志文件比对话还臃肿;v2.1 改成增量检查、寒暄轮零写盘;实际使用才发现「中途终止、进度全丢」这个最疼的坑,v2.2 补上每步即时写盘。没有一版是生下来就对的。
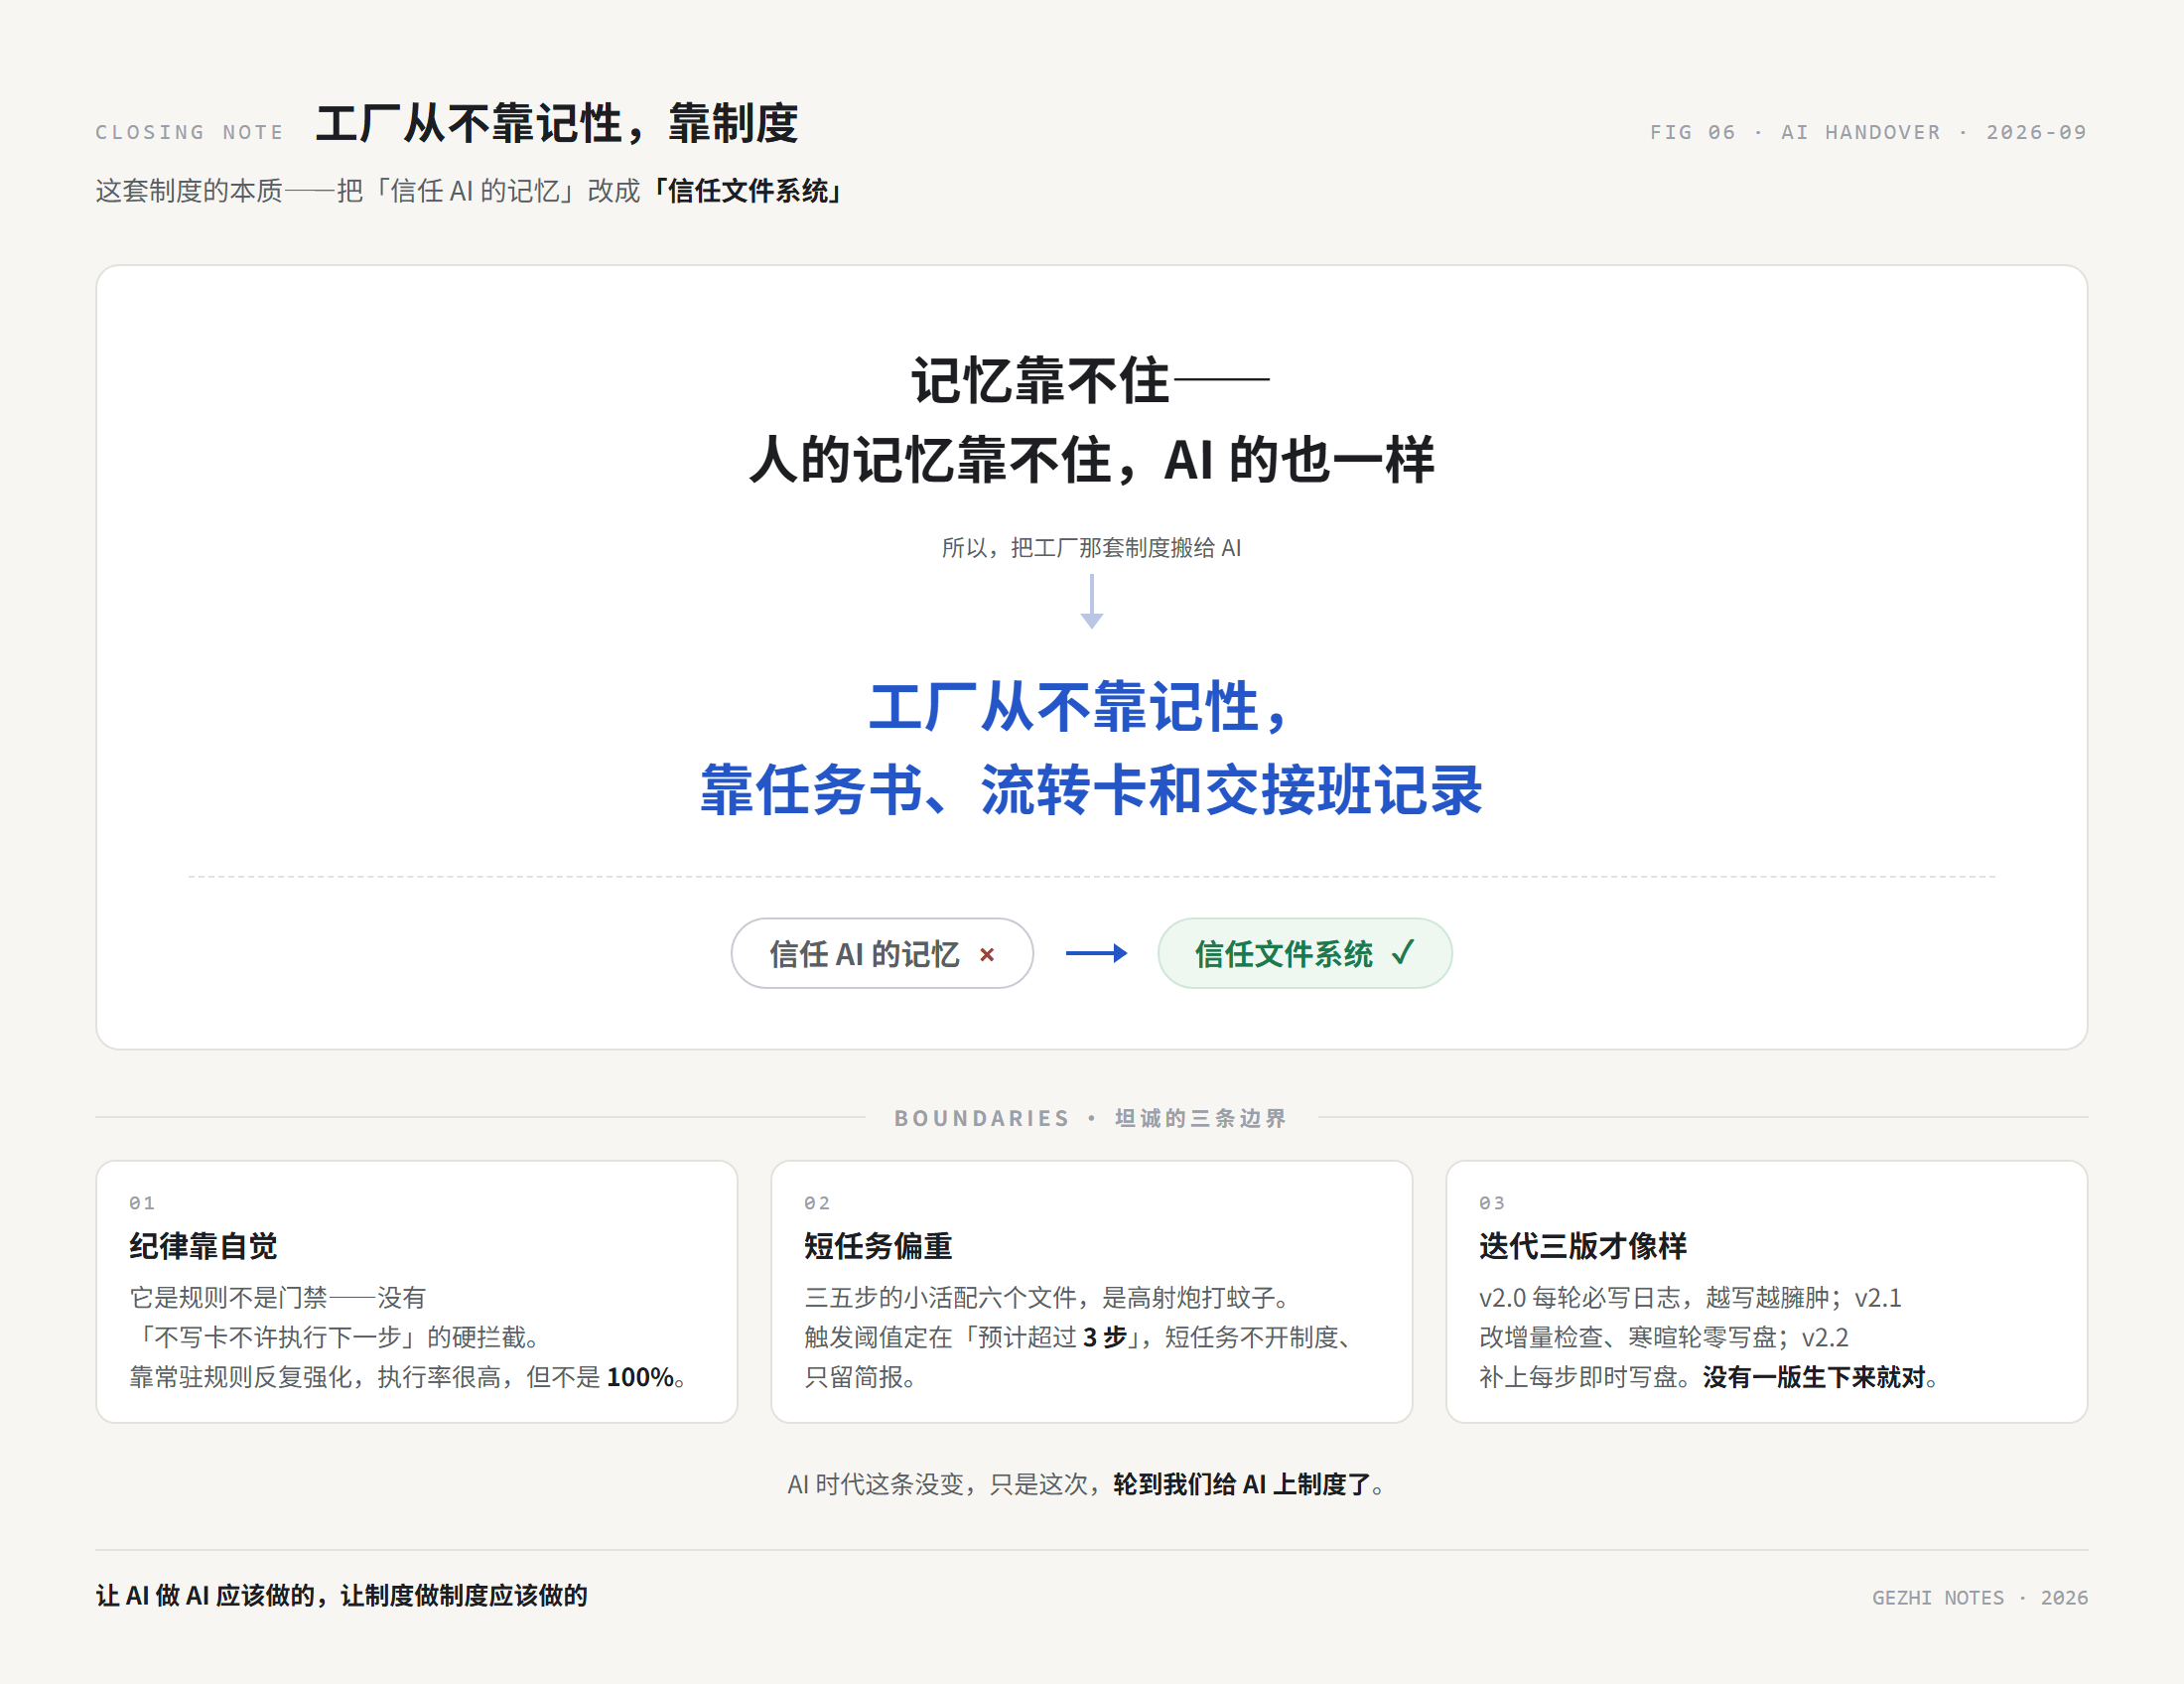
但它的本质是对的:把「信任 AI 的记忆」改成「信任文件系统」。 记忆靠不住——人的记忆靠不住,AI 的也一样;所以工厂从不靠记性,靠任务书、流转卡和交接班记录。AI 时代这条没变,只是这次,轮到我们给 AI 上制度了。
让 AI 做 AI 应该做的,让制度做制度应该做的。